

Évaluer des modèles avec Weave
W&B Weave est une boîte à outils spécialement conçue pour évaluer les LLM et les applications d’IA générative. Elle offre des fonctionnalités d’évaluation complètes, notamment des évaluateurs, des juges et un Tracing détaillé, pour vous aider à comprendre et à améliorer les performances du modèle. Weave s’intègre à W&B Models, ce qui vous permet d’évaluer les modèles stockés dans votre registre de modèles.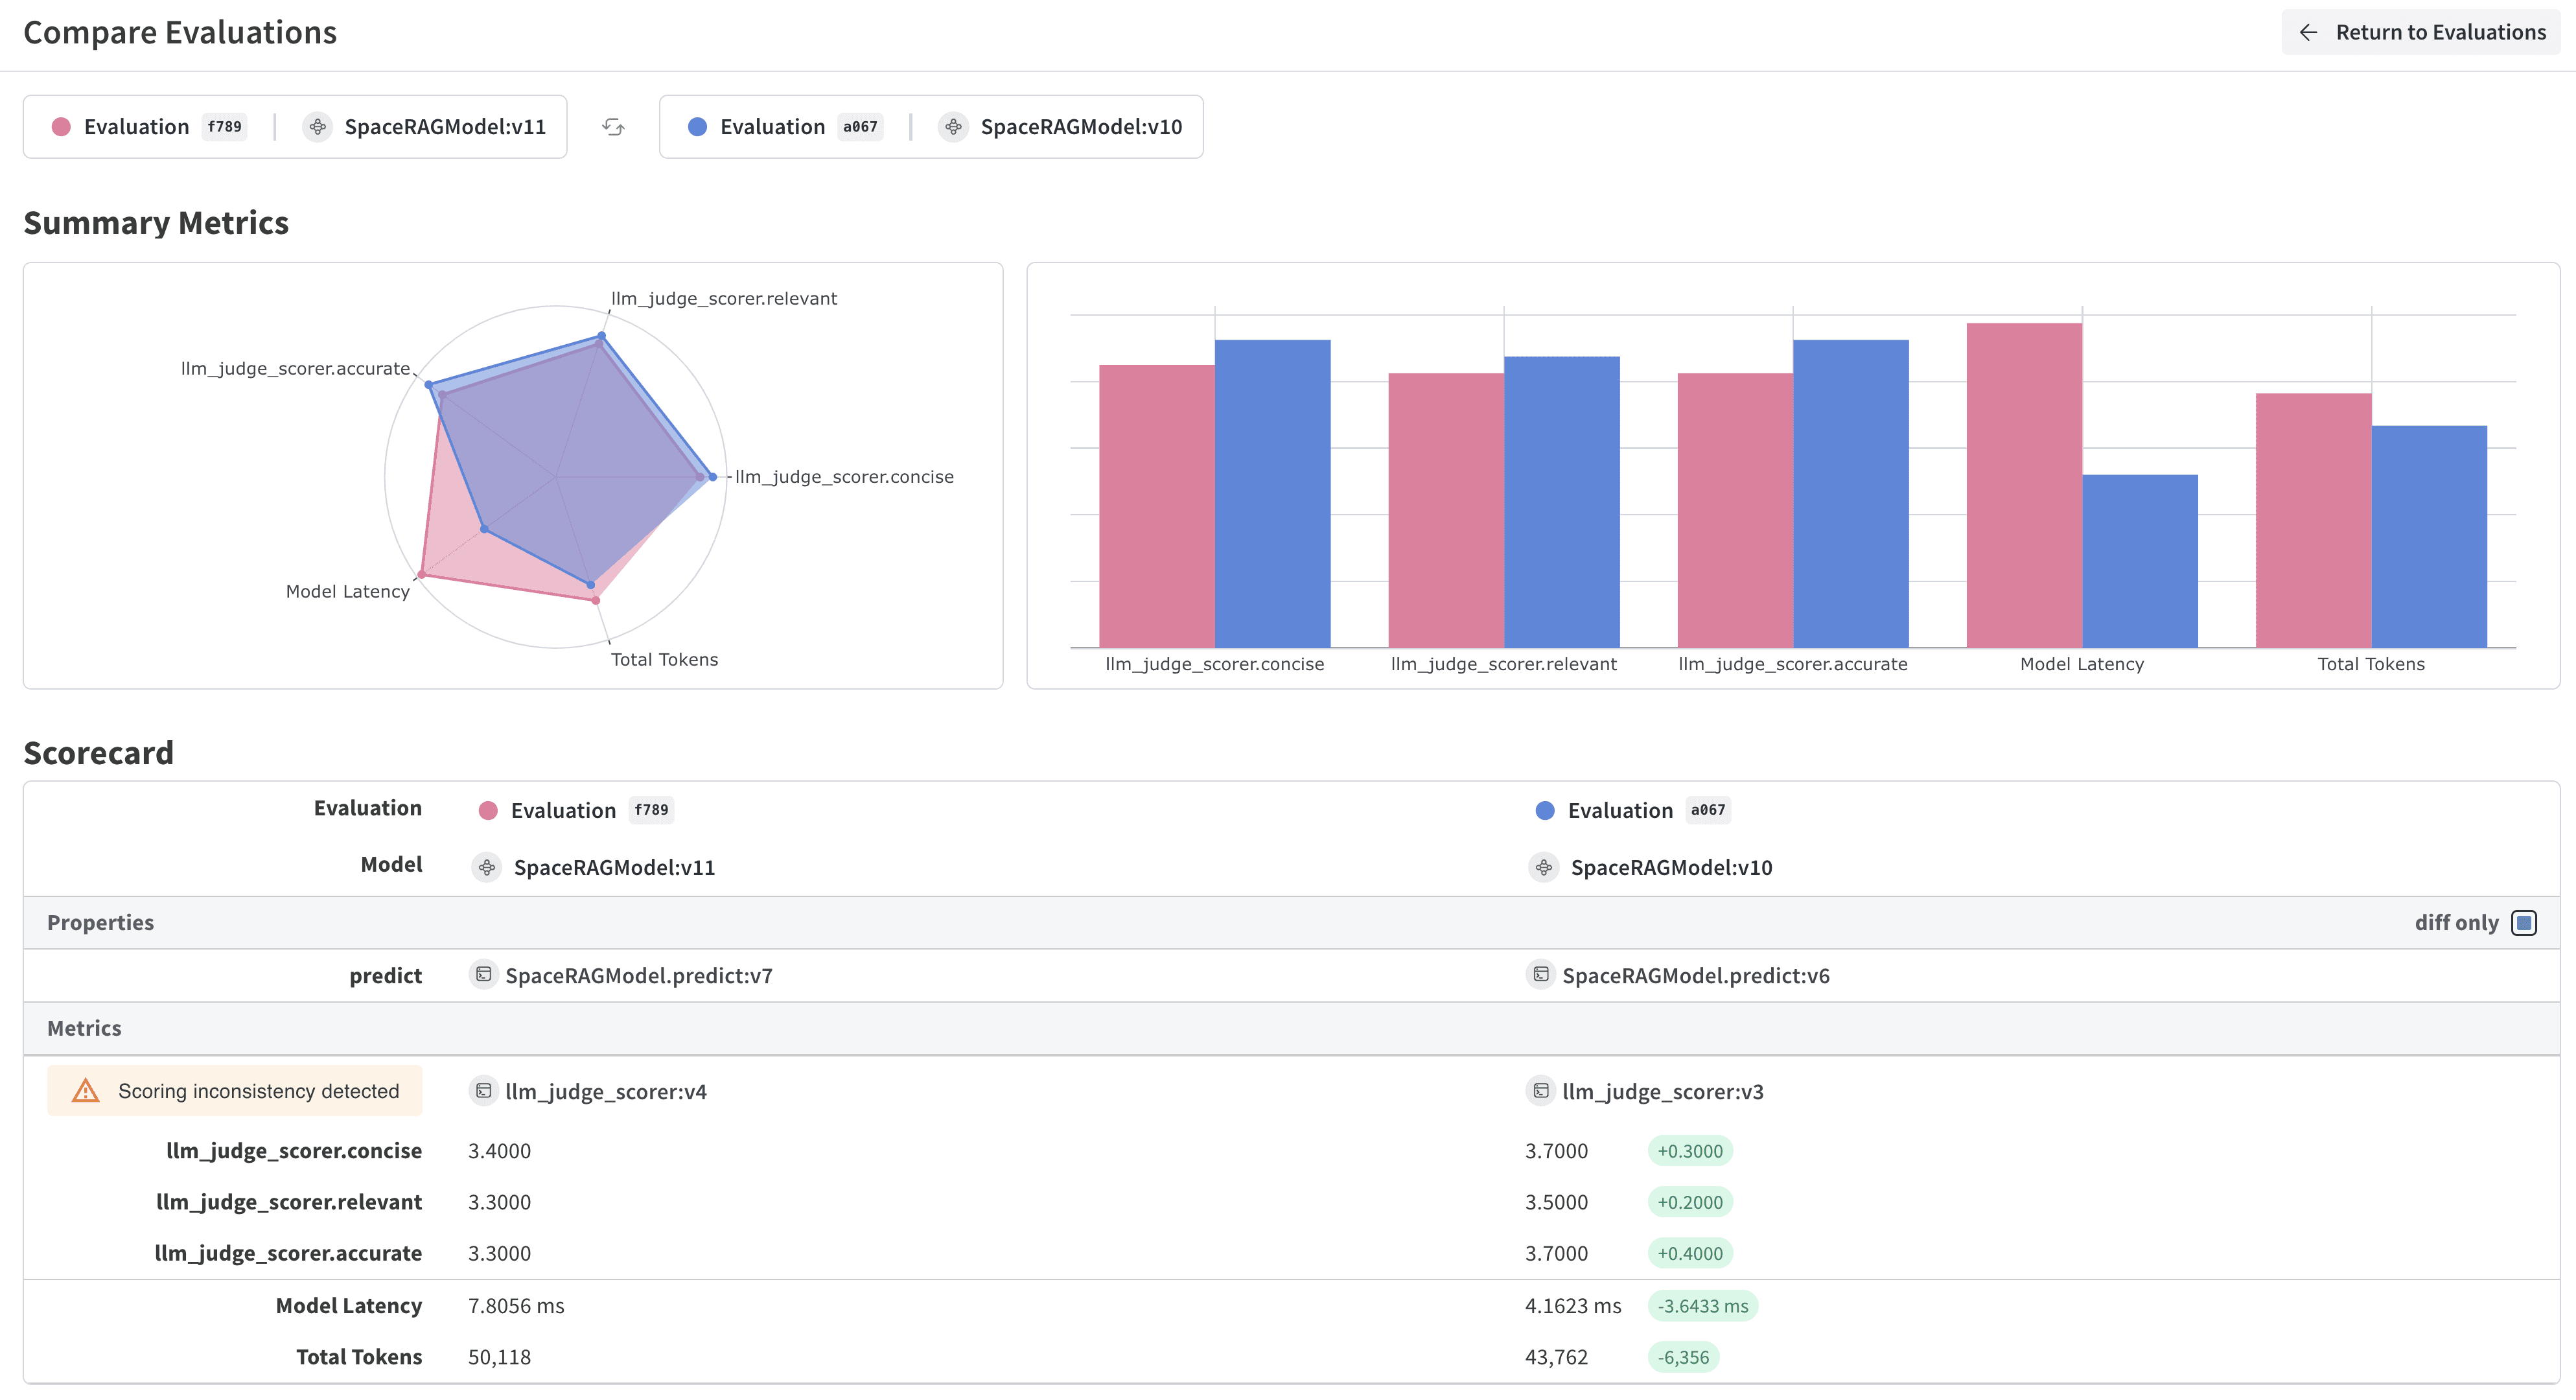
Fonctionnalités clés pour l’évaluation des modèles
- Évaluateurs et juges : Métriques d’évaluation prédéfinies et personnalisées pour l’exactitude, la pertinence, la cohérence, etc.
- Jeux de données d’évaluation : Ensembles de test structurés avec des valeurs de référence pour une évaluation systématique
- Gestion des versions des modèles : Suivez et comparez différentes versions de vos modèles
- Tracing détaillé : Déboguez le comportement du modèle à l’aide de traces d’entrée/sortie complètes
- Suivi des coûts : Surveillez les coûts d’API et l’utilisation des tokens sur l’ensemble des évaluations
Premiers pas : évaluer un modèle à partir du registre W&B
Téléchargez un modèle depuis le registre de W&B Models et évaluez-le avec Weave :Intégrer les évaluations Weave à W&B Models
La exemple d’intégration entre Models et Weave présente le flux de travail complet pour :- Charger des modèles depuis le registre : téléchargez des modèles affinés stockés dans le registre de W&B Models
- Créer des pipelines d’évaluation : créez des évaluations complètes avec des évaluateurs personnalisés
- Journaliser les résultats dans W&B : associez les métriques d’évaluation aux runs de vos modèles
- Versionner les modèles évalués : enregistrez les modèles améliorés dans le registre
Fonctionnalités avancées de Weave
Évaluateurs et juges personnalisés
Créez des métriques d’évaluation sophistiquées adaptées à votre cas d’utilisation :Évaluations par lot
Évaluez plusieurs versions de modèle ou plusieurs configurations :Étapes suivantes
Évaluer des modèles avec W&B Tables
Utilisez W&B Tables pour :- Comparer les prédictions des modèles : affichez côte à côte les performances de différents modèles sur le même jeu de test
- Suivre l’évolution des prédictions : observez comment les prédictions changent au fil des époques d’entraînement ou des versions du modèle
- Analyser les erreurs : filtrez et lancez des requêtes pour trouver les exemples fréquemment mal classés et les schémas d’erreur
- Visualiser des médias enrichis : affichez des images, de l’Audio, du texte et d’autres types de médias à côté des prédictions et des métriques

Exemple de base : Enregistrer les résultats d’évaluation
Flux de travail avancés avec les tableaux
Comparer plusieurs modèles
Journalisez les tableaux d’eval de différents modèles avec la même clé afin de les comparer directement :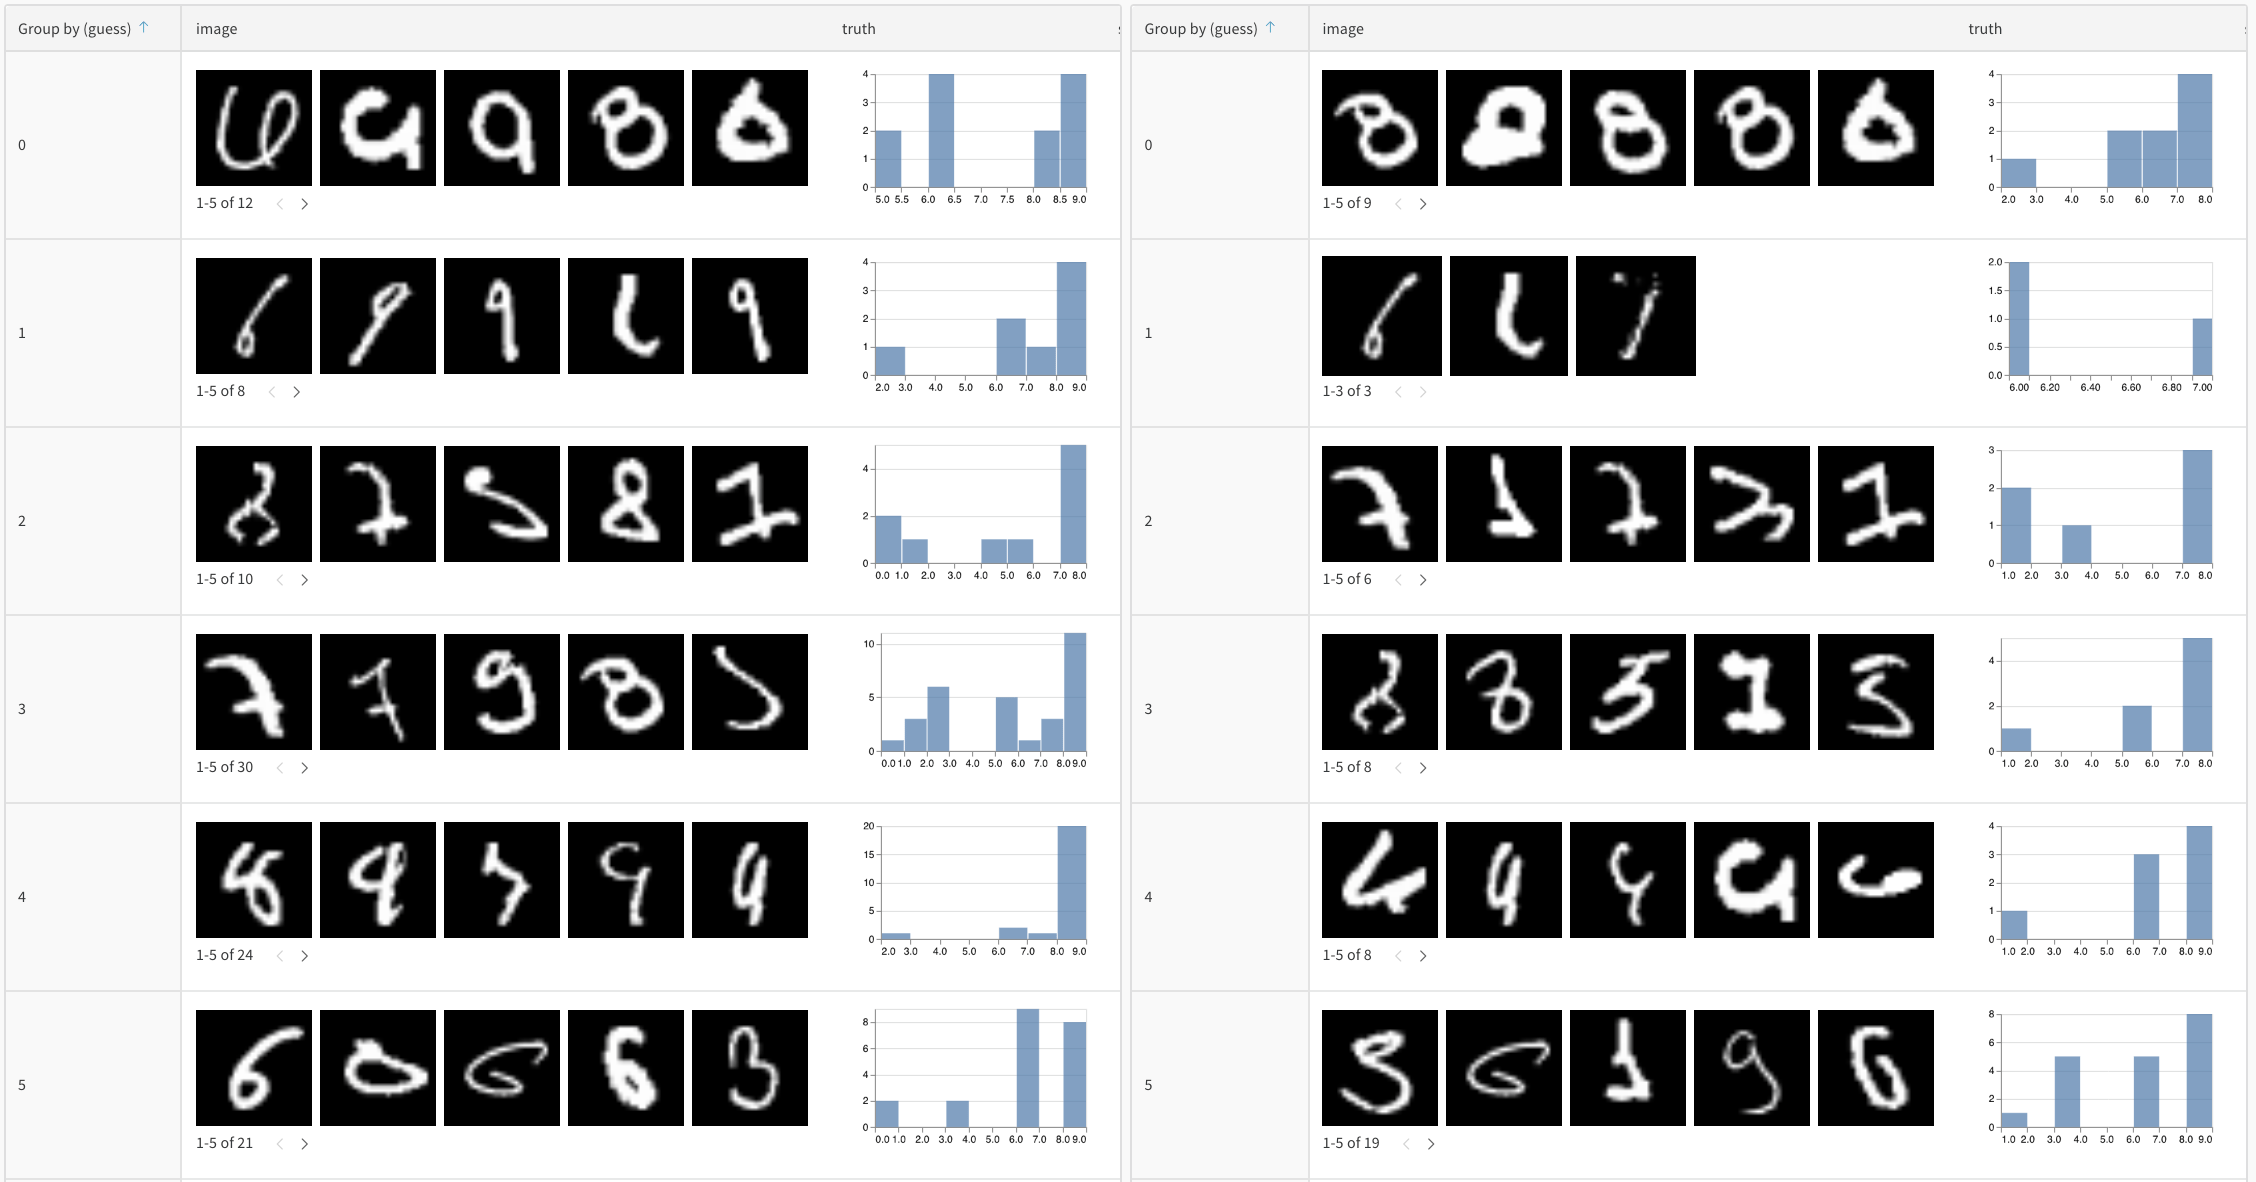
Suivre les prédictions au fil du temps
Journalisez des tableaux dans le journal à différentes époques d’entraînement pour visualiser les améliorations :Analyse interactive dans l’interface W&B
Une fois les résultats enregistrés, vous pouvez :- Filtrer les résultats : cliquez sur les en-têtes de colonne pour filtrer selon la précision des prédictions, les seuils de confiance ou des classes spécifiques
- Comparer des tables : sélectionnez plusieurs versions de table pour afficher des comparaisons côte à côte
- Interroger les données : utilisez la barre de requête pour trouver des motifs précis (par exemple,
"correct" = false AND "confidence" > 0.8) - Grouper et agréger : regroupez par classe prédite pour voir les métriques de précision par classe
