

Weave でモデルを評価する
W&B Weave は、LLM や GenAI アプリケーションの評価に特化したツールキットです。スコアラー、ジャッジ、詳細なトレースなど、包括的な評価機能を備えており、モデル性能の把握と改善に役立ちます。Weave は W&B Models と統合されているため、Model Registry に保存されたモデルを評価できます。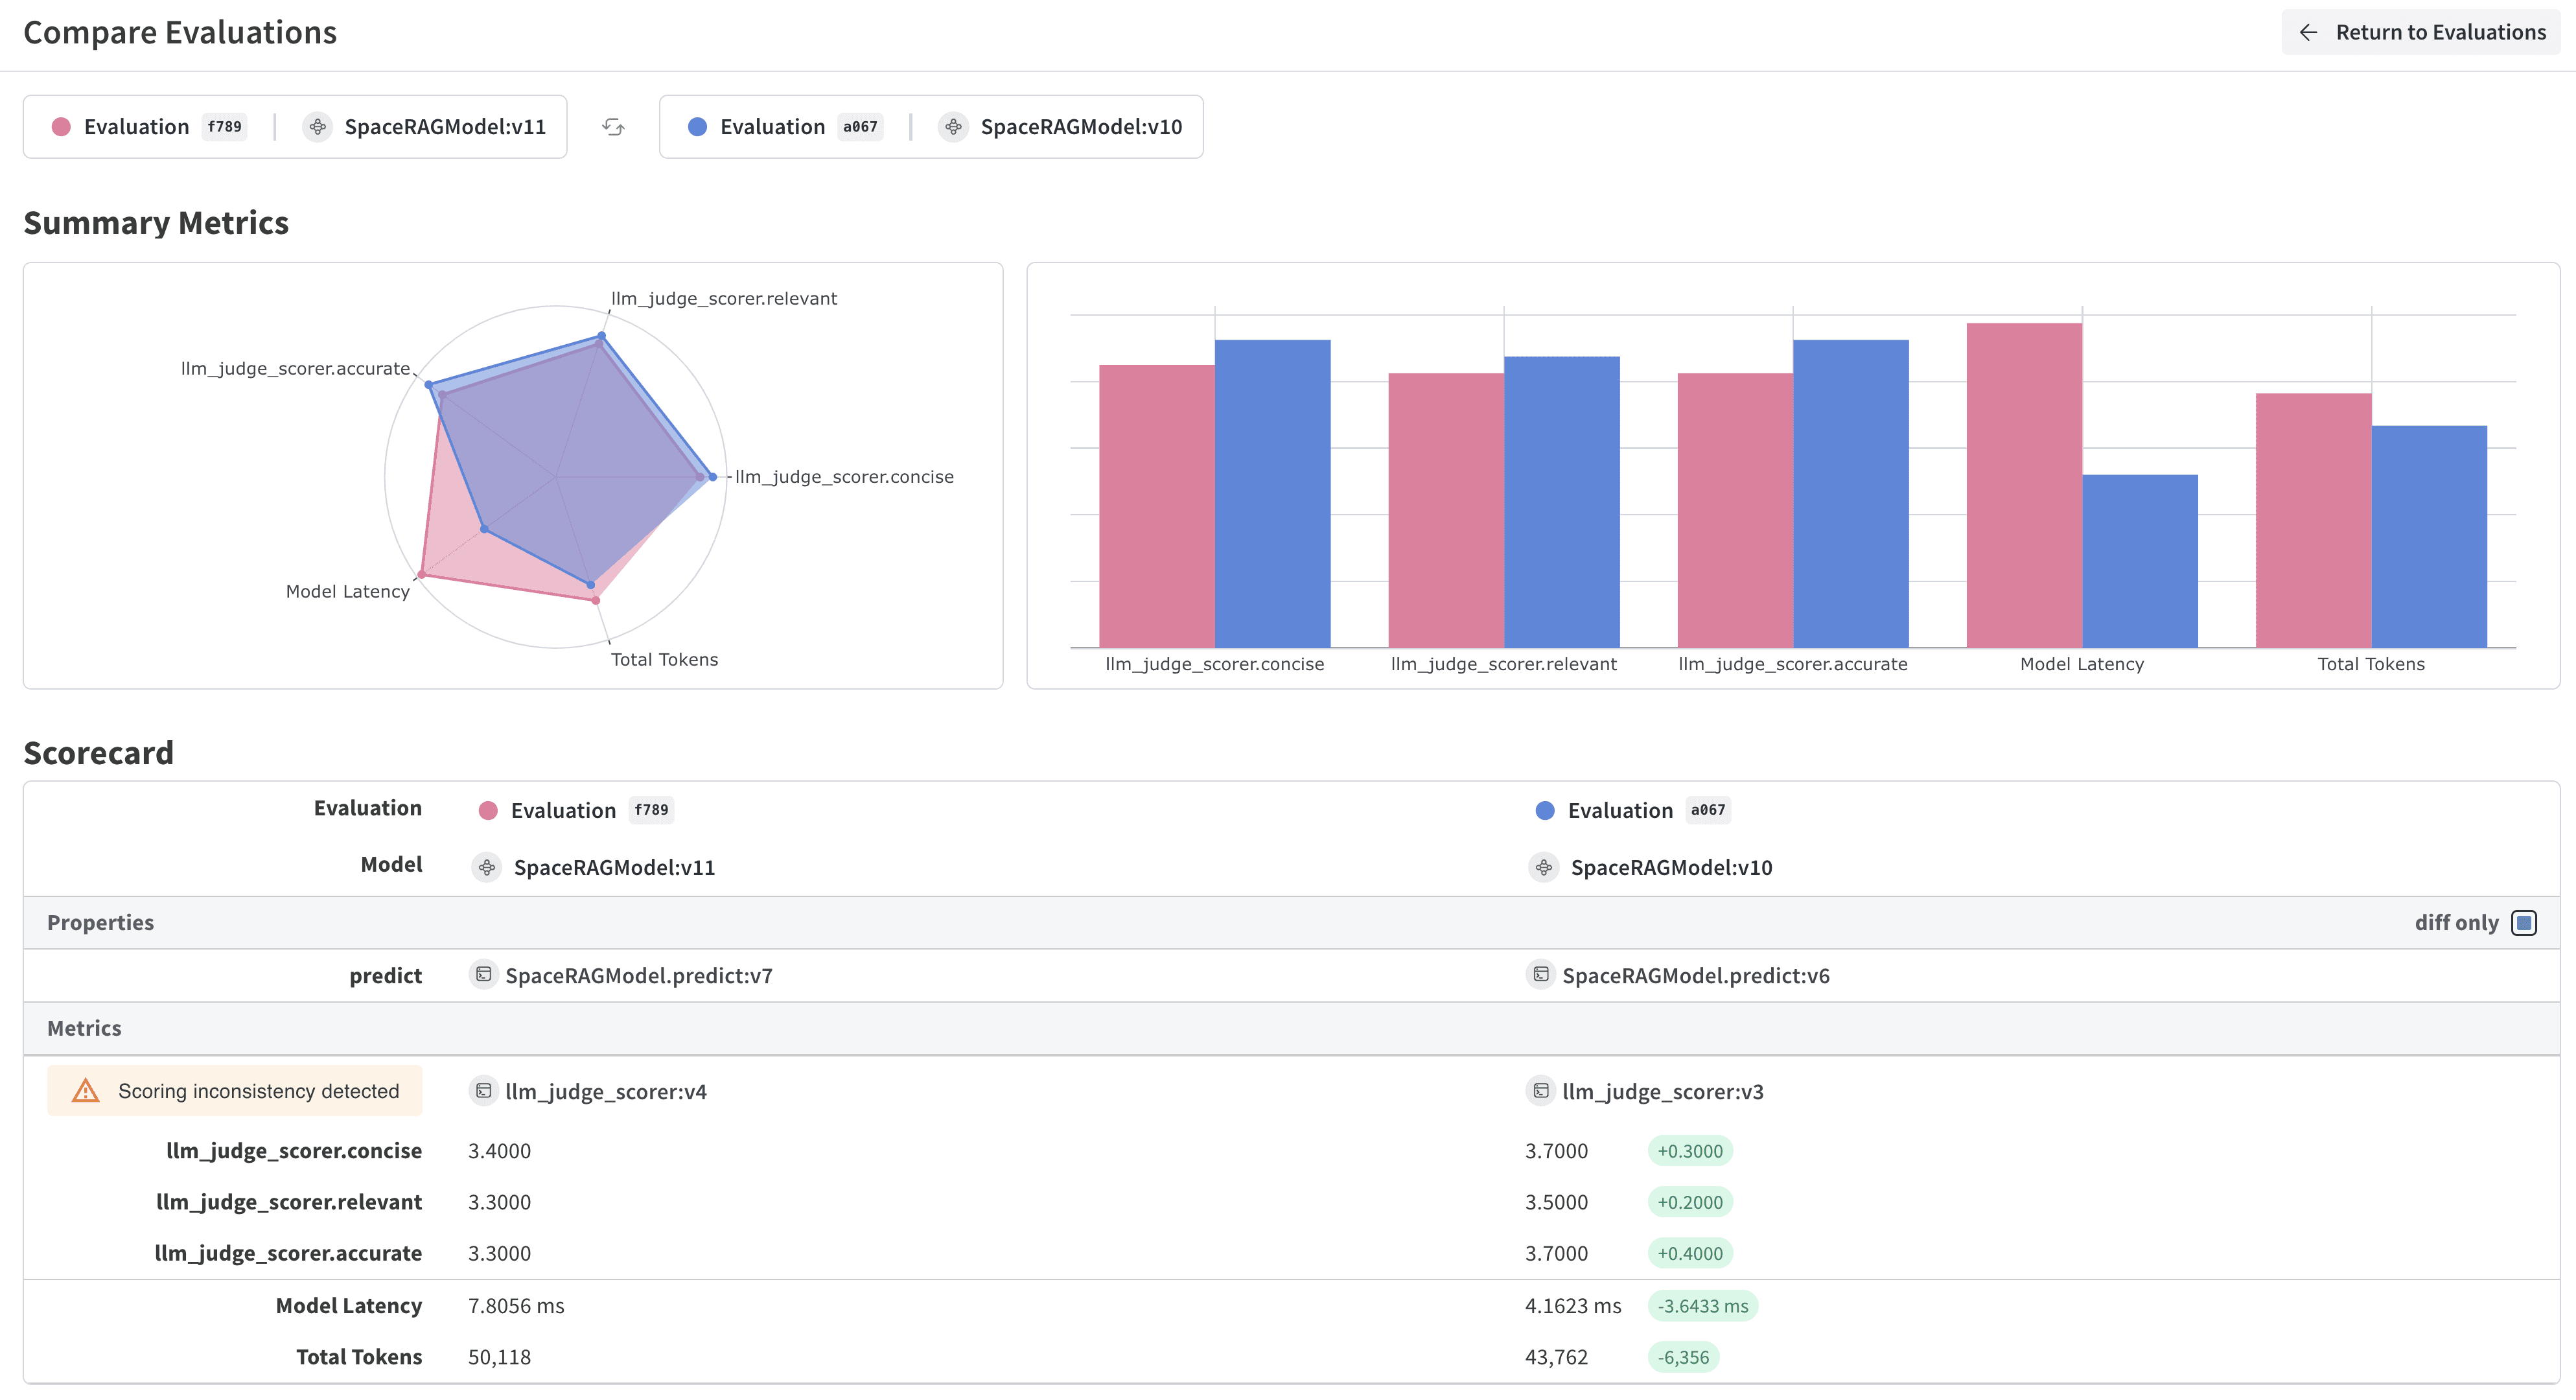
モデル評価の主な機能
- Scorers と ジャッジ: 精度、関連性、一貫性などに対応した、組み込みおよびカスタムの評価メトリクス
- 評価用データセット: 系統的な評価のための、正解データを含む構造化されたテストセット
- モデルのバージョン管理: モデルの異なるバージョンをトラッキングして比較
- 詳細なトレース: 完全な入出力トレースでモデルの挙動をデバッグ
- コストのトラッキング: 評価全体での API コストとトークン使用量を監視
はじめに: W&B Registry のモデルを評価する
W&B Models Registry からモデルをダウンロードし、Weave を使って評価します:Weave の評価を W&B Models と統合する
Models と Weave のインテグレーション例 では、次の一連のワークフロー全体を確認できます。- Registry からモデルを読み込む: W&B Models Registry に保存されたファインチューニング済みモデルをダウンロードする
- 評価パイプラインを作成する: カスタム Scorer を使用して包括的な評価を構築する
- 結果を W&B にログする: 評価メトリクスをモデルの run に関連付ける
- 評価済みモデルをバージョン管理する: 改善したモデルを Registry に保存し直す
Weave の高度な機能
カスタムスコアラーとジャッジ
ユースケースに合わせて、高度な評価メトリクスを作成できます:バッチ評価
複数のモデルバージョンまたは設定を評価します:次のステップ
Tablesでモデルを評価する
W&B Tables を使用すると、次のことができます。- モデルの予測を比較する: 同じテストセットに対する複数のモデルのパフォーマンスを並べて比較できます
- 予測の変化をトラッキングする: トレーニングのエポックやモデルバージョンごとに、予測がどのように変化するかを追跡できます
- エラーを分析する: フィルターやクエリを使用して、誤分類されやすい例やエラーパターンを見つけられます
- リッチメディアを可視化する: 画像、オーディオ、テキストなどのメディアタイプを、予測やメトリクスとあわせて表示できます

基本例: 評価結果をログする
表を使った高度なワークフロー
複数のモデルを比較
異なるモデルの評価テーブルを同じキーにログして、直接比較します。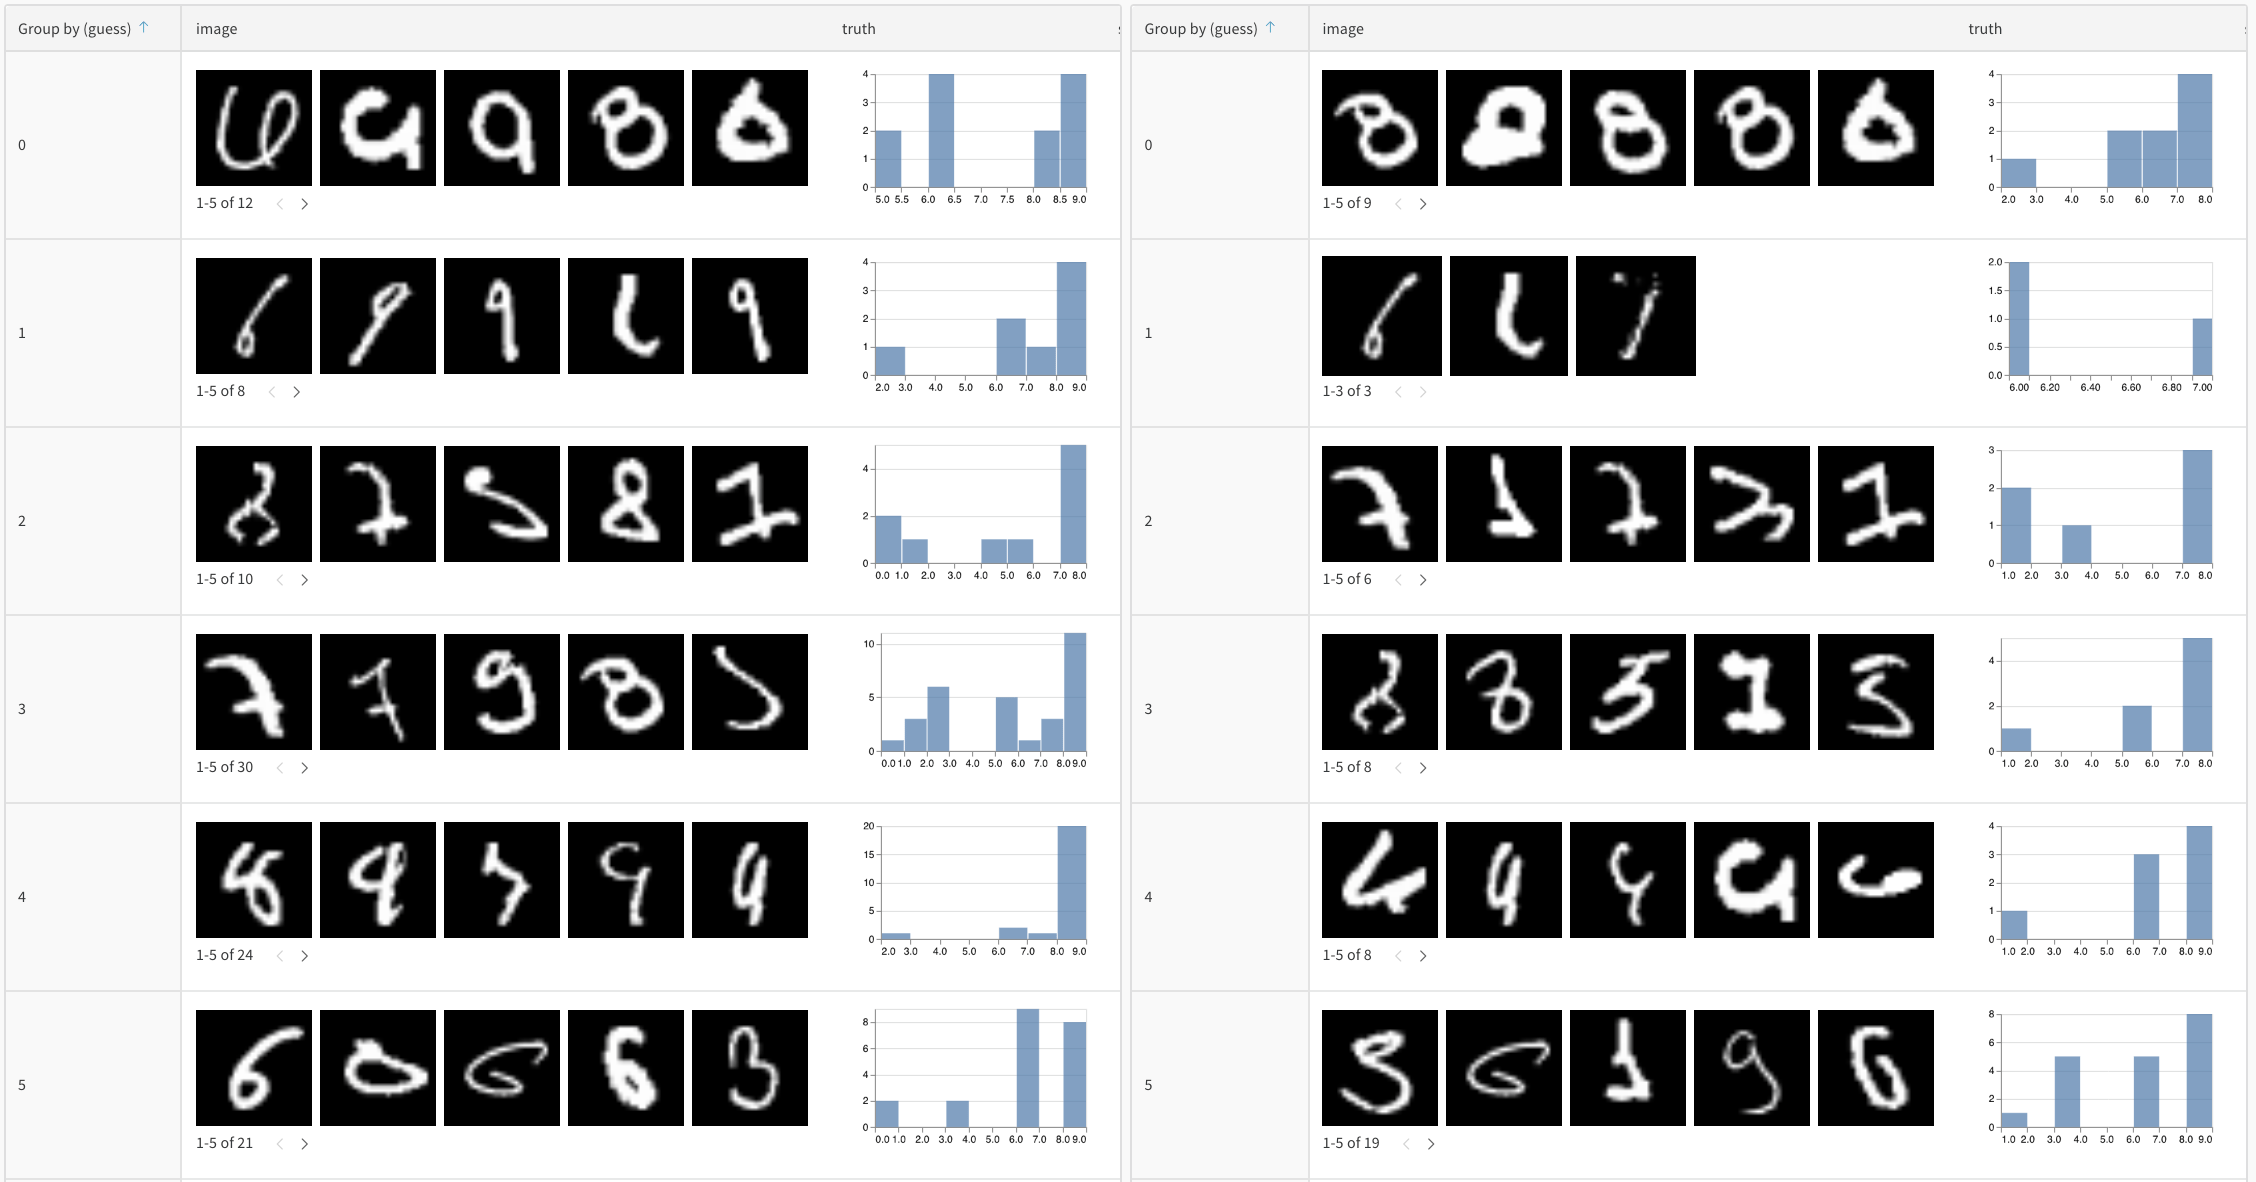
予測の推移をトラッキングする
改善を可視化するには、トレーニングの異なるエポックごとに表をログします:W&B UI でのインタラクティブな分析
記録後は、次のことができます。- 結果をフィルター: 列ヘッダーをクリックして、予測精度、信頼度のしきい値、特定のクラスで絞り込みます
- テーブルを比較: 複数のテーブルバージョンを選択して、並べて比較できます
- データをクエリ: クエリバーを使用して特定のパターンを検索します (例:
"correct" = false AND "confidence" > 0.8) - グループ化と集計: 予測クラスでグループ化して、クラスごとの精度メトリクスを確認します
