

Exemple de base : traçage de Llama 3.1 8B avec Weave
Cet exemple montre comment envoyer un prompt au modèle Llama 3.1 8B et tracer l’appel avec Weave. Le traçage capture l’intégralité des entrées et des sorties de l’appel LLM, surveille les performances et vous permet d’analyser les résultats dans la Weave UI. Dans cet exemple :- Vous définissez une fonction décorée avec
@weave.op()qui effectue une requête de Chat Completion. - Weave enregistre vos traces et les associe à votre entité et à votre projet W&B.
- Weave trace automatiquement la fonction, avec journalisation des entrées, des sorties, de la latence et des métadonnées.
- Le résultat s’affiche dans le terminal, et la trace apparaît dans votre onglet Traces sur https://wandb.ai.
- Cliquez sur le lien affiché dans le terminal. Par exemple,
https://wandb.ai/[YOUR-TEAM]/[YOUR-PROJECT]/r/call/01977f8f-839d-7dda-b0c2-27292ef0e04g. - Accédez à https://wandb.ai et sélectionnez l’onglet Traces.
Exemple avancé : utiliser Weave évaluations et les leaderboards
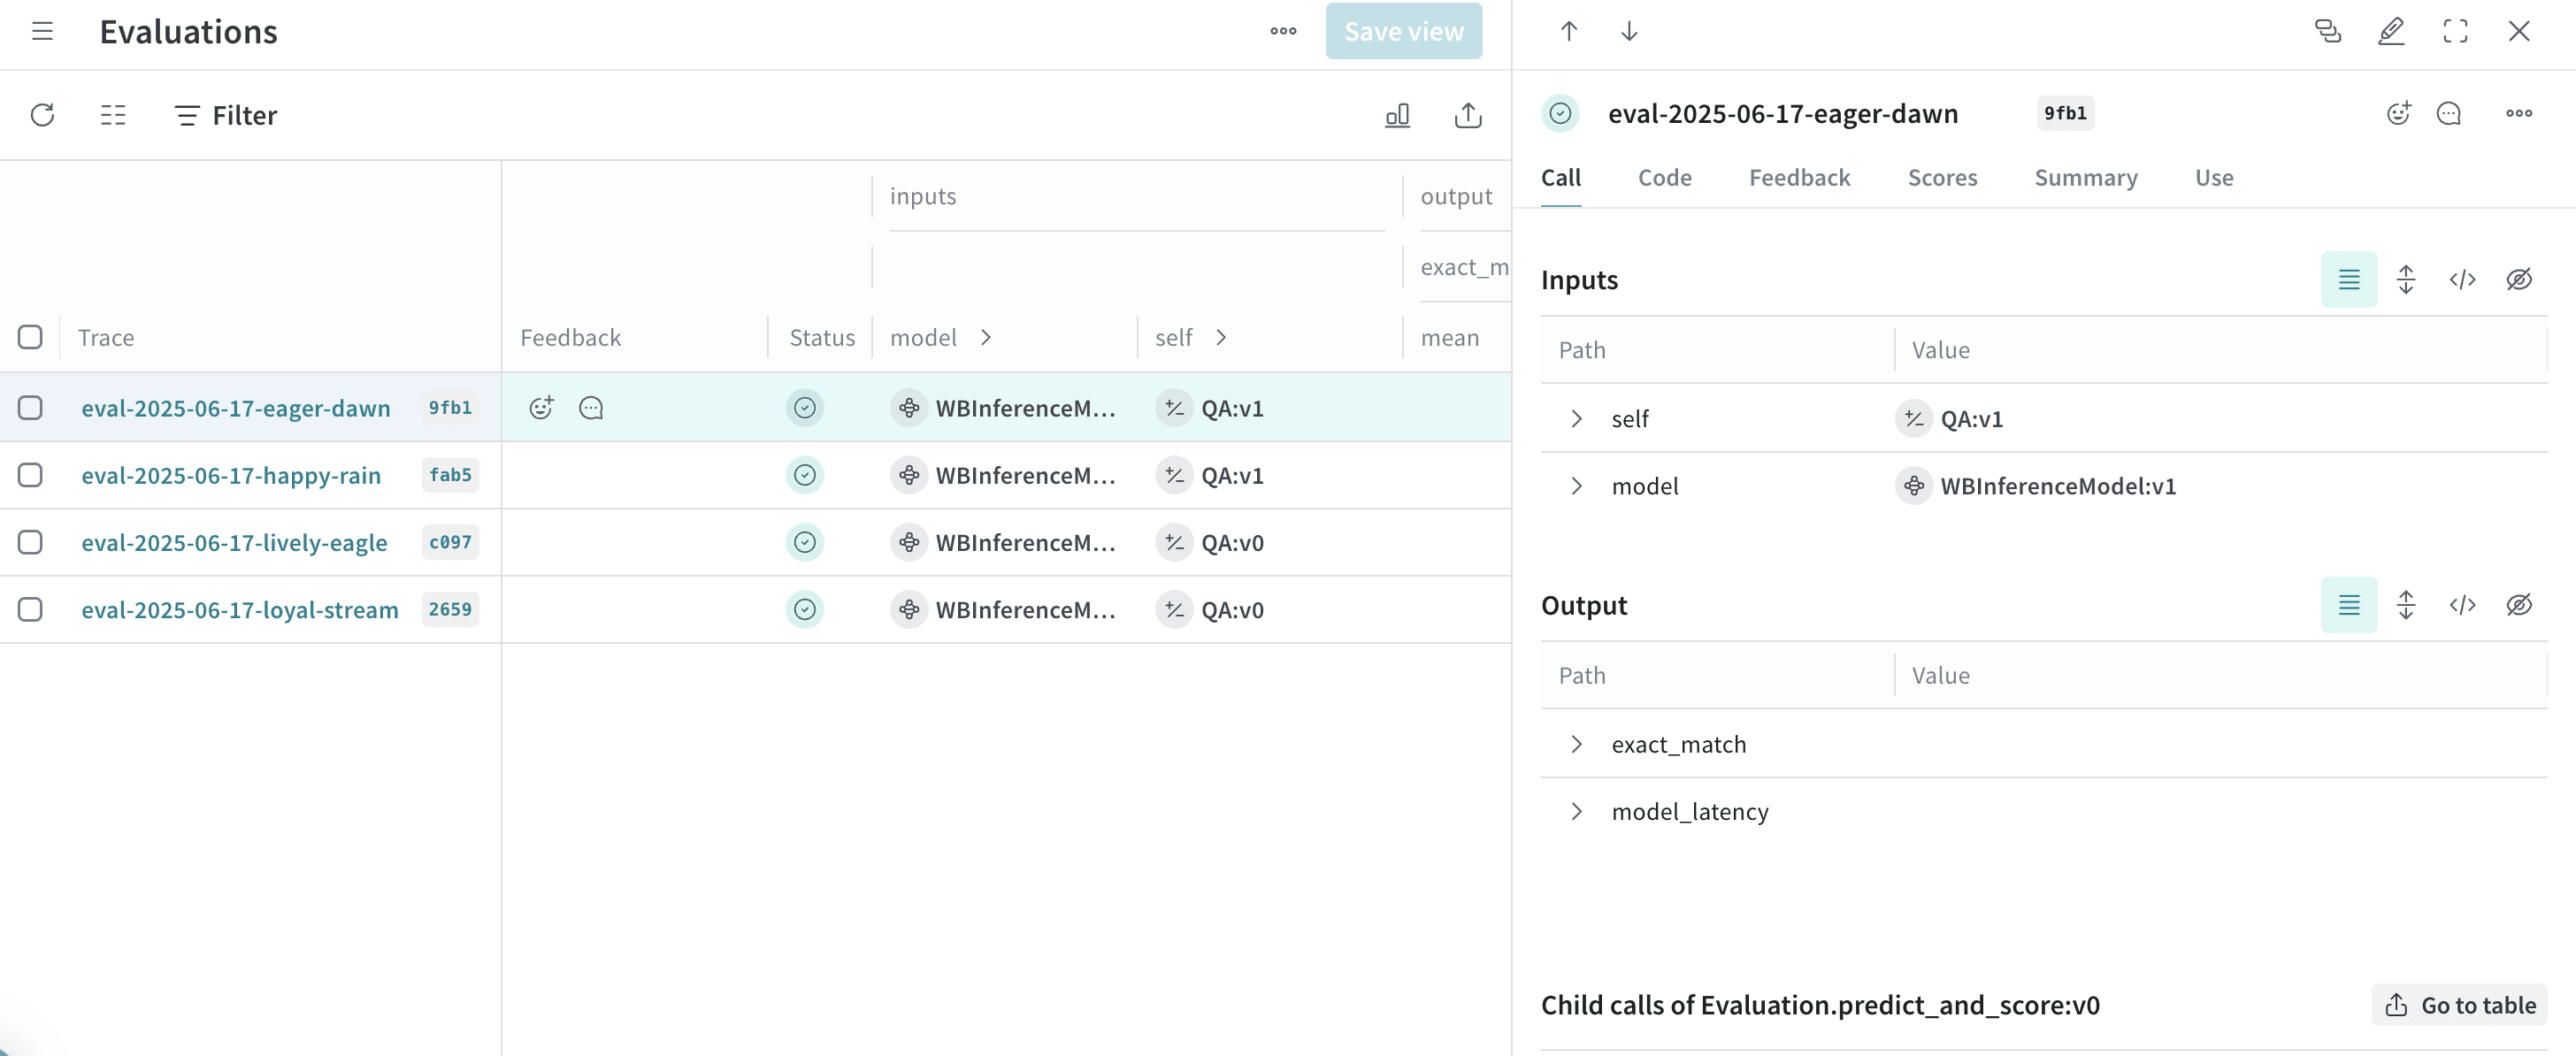
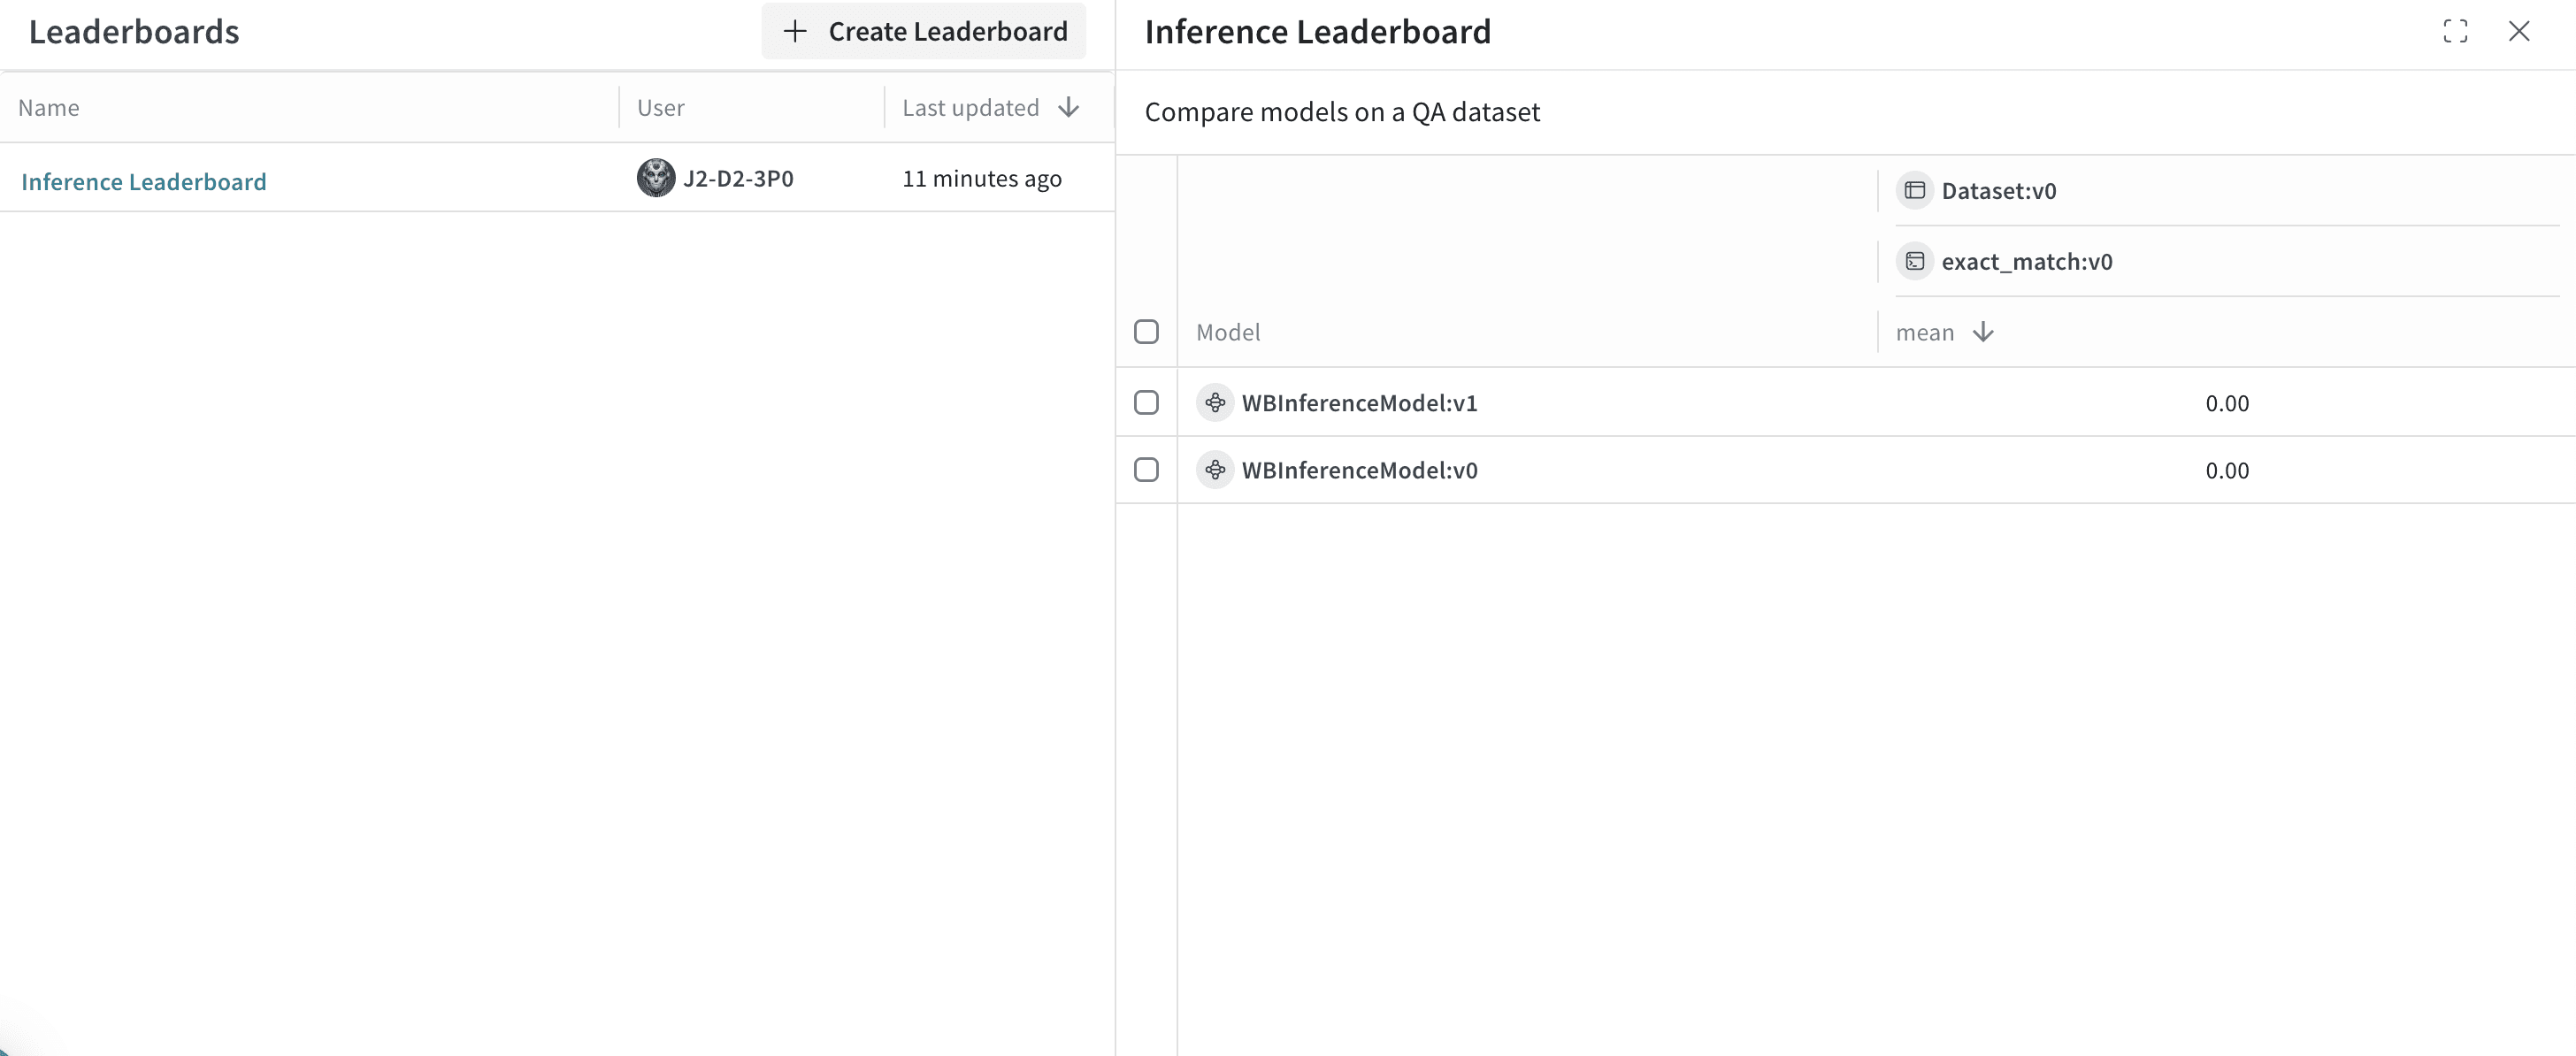
En plus du traçage des appels de modèle, vous pouvez évaluer les performances et publier des leaderboards. Cet exemple compare deux modèles sur un jeu de données de questions-réponses pour montrer comment Llama 3.1 8B et DeepSeek V3.1 se comportent avec les mêmes prompts.- Sélectionnez l’onglet Traces pour consulter vos traces.
- Sélectionnez l’onglet Evals pour consulter les évaluations de votre modèle.
- Sélectionnez l’onglet Leaders pour consulter le leaderboard généré.
Étapes suivantes
Pour continuer à explorer Serverless Inference, essayez ce qui suit :- Explorez la référence de l’API pour découvrir toutes les méthodes disponibles.
- Essayez des modèles dans l’UI.