Il s’agit d’un notebook interactif. Vous pouvez l’exécuter en local ou utiliser les liens suivants :
Installer les dépendances
Avant de commencer, installez les bibliothèques utilisées tout au long du tutoriel. Ce tutoriel utilise les bibliothèques suivantes :- DSPy pour construire et optimiser le flux de travail LLM.
- Weave pour suivre le flux de travail LLM et évaluer les stratégies de prompting.
- datasets pour accéder au jeu de données BIG-Bench Hard depuis le Hub Hugging Face.
Activer le suivi avec Weave
Cette section configure Weave afin que les appels DSPy suivants du tutoriel soient automatiquement tracés et visibles dans l’interface Weave. Weave s’intègre à DSPy. Inclureweave.init au début de votre code permet de tracer automatiquement vos fonctions DSPy, que vous pouvez ensuite explorer dans l’interface Weave. Pour plus d’informations, voir la documentation de l’intégration Weave pour DSPy.
weave.Object pour gérer les métadonnées.
Charger le jeu de données BIG-Bench Hard
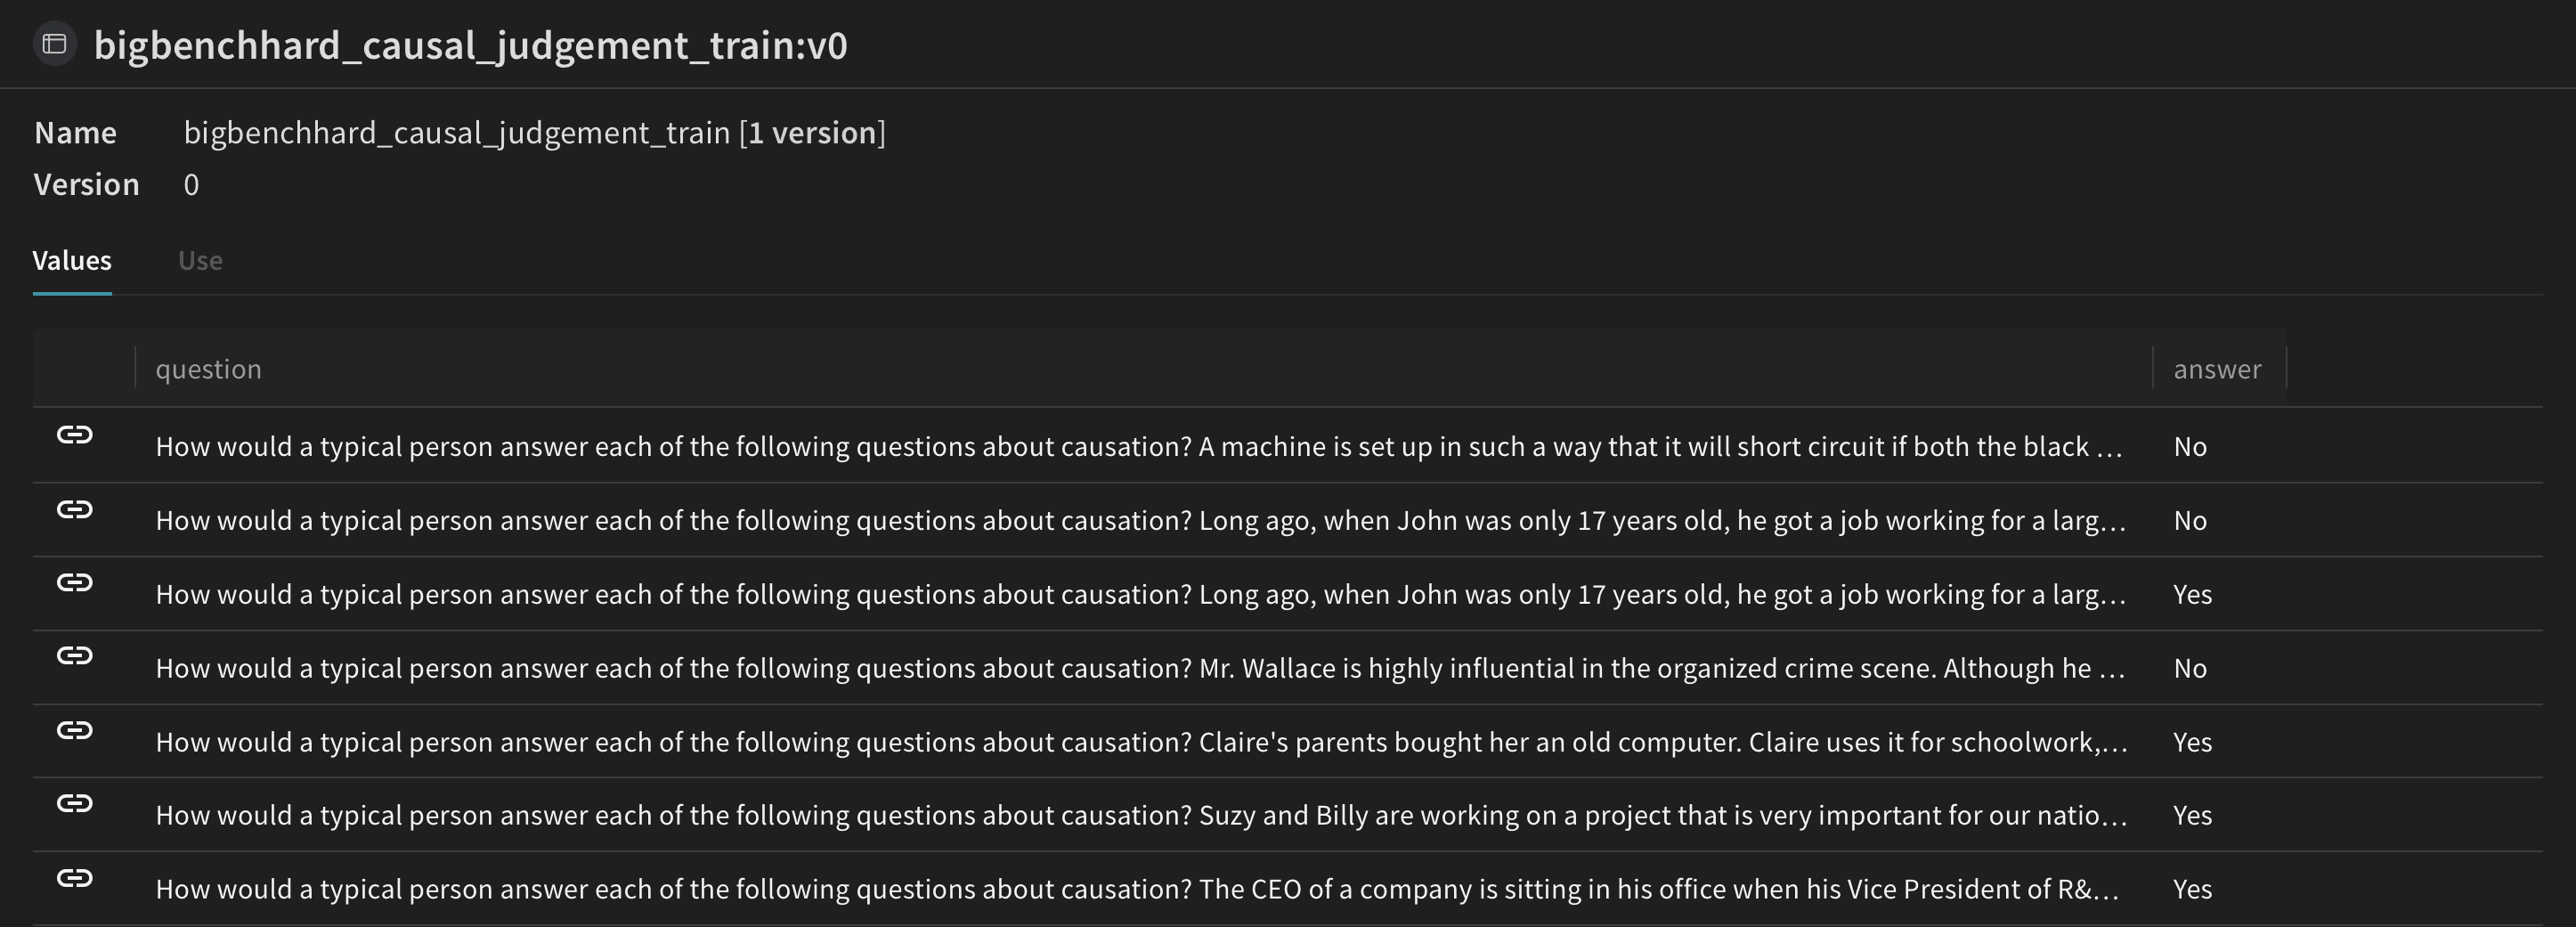
Une fois le suivi Weave activé, l’étape suivante consiste à préparer les données utilisées pour entraîner et évaluer le programme DSPy. Chargez ce jeu de données à partir de Hugging Face Hub, répartissez-le en ensembles d’entraînement et de validation, puis publiez-les sur Weave. La publication vous permet de versionner les jeux de données et d’utiliser égalementweave.Evaluation pour évaluer votre stratégie de prompting.
Le programme DSPy
Une fois le jeu de données publié vers Weave, vous pouvez désormais définir le programme DSPy de référence que vous évaluerez et optimiserez par la suite. DSPy est un framework qui déplace la création de nouveaux pipelines de LM de la manipulation de chaînes de texte libres vers la programmation (en composant des opérateurs modulaires pour construire des graphes de transformation de texte), où un compilateur génère automatiquement, à partir d’un programme, des stratégies d’invocation de LM et des prompts optimisés. Utilisezdspy.LM pour configurer le modèle de langage et dspy.configure pour le définir comme valeur par défaut.
Écrire la signature du raisonnement causal
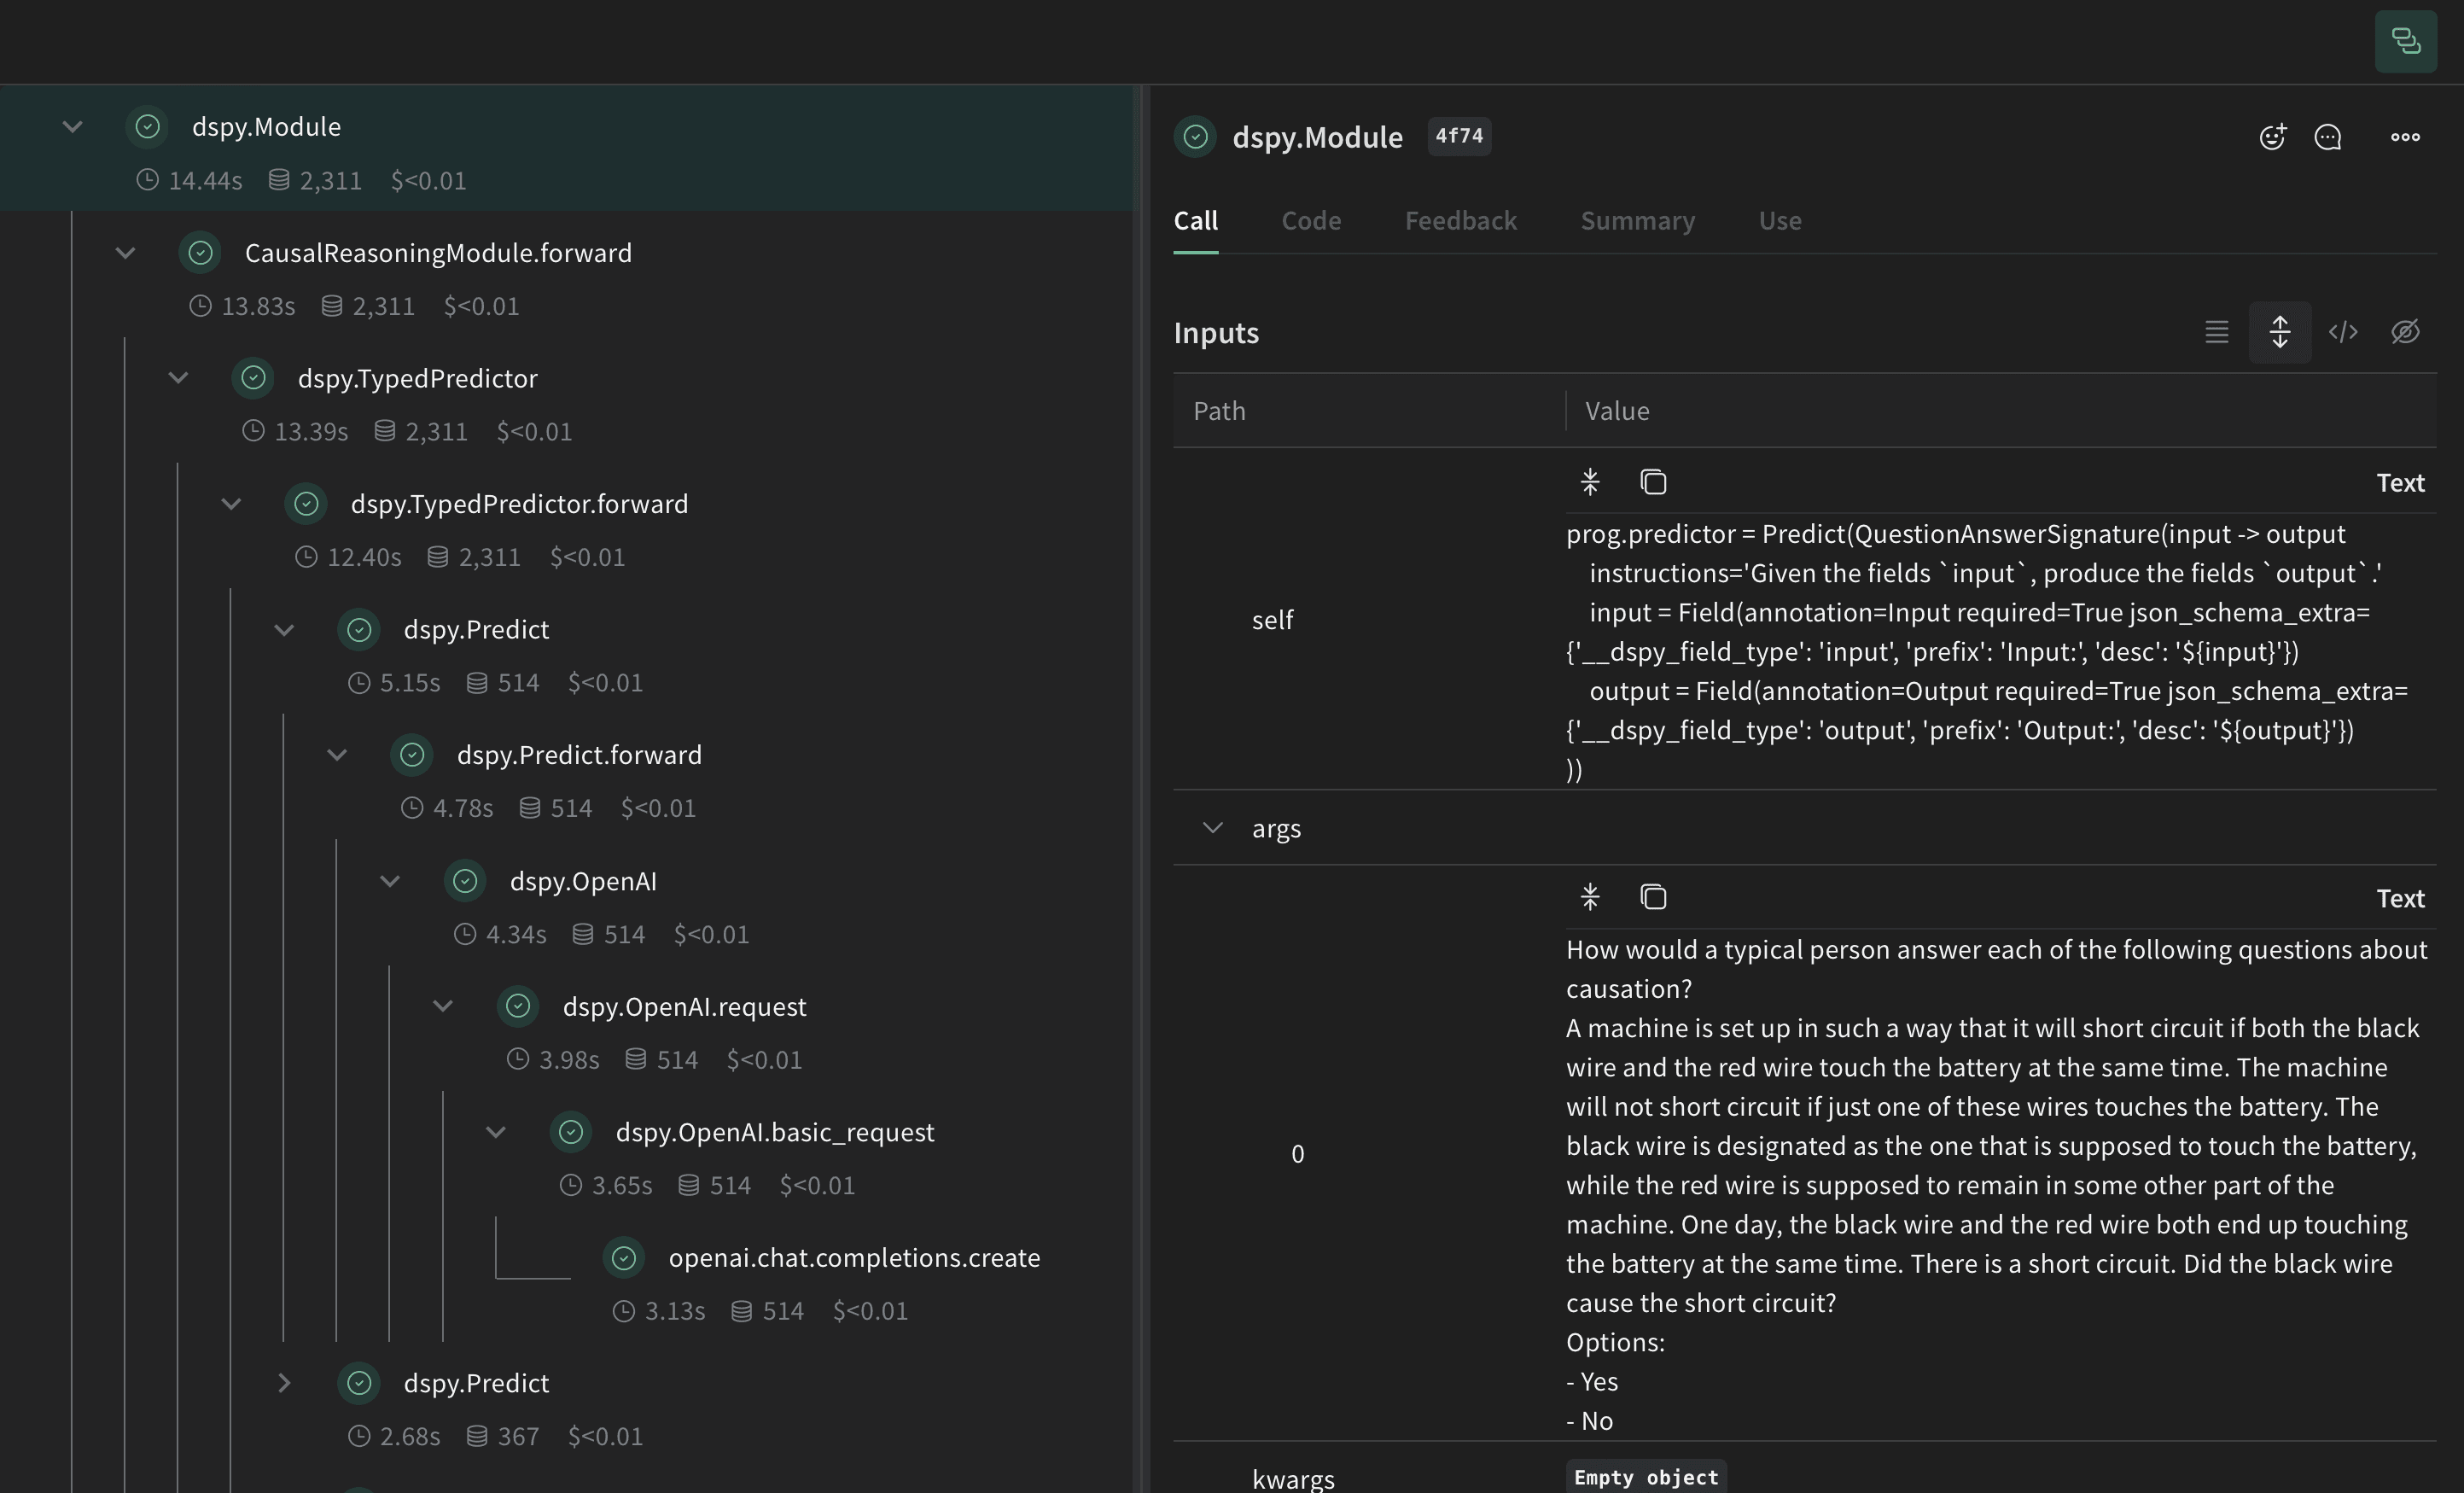
Une signature est une spécification déclarative du comportement en entrée/sortie d’un module DSPy. Les modules DSPy sont des composants adaptatifs à la tâche — comparables à des couches de réseau de neurones — qui font abstraction de toute transformation de texte particulière.CausalReasoningModule, sur un exemple tiré du sous-ensemble de raisonnement causal de BIG-Bench Hard.
Évaluez le programme DSPy
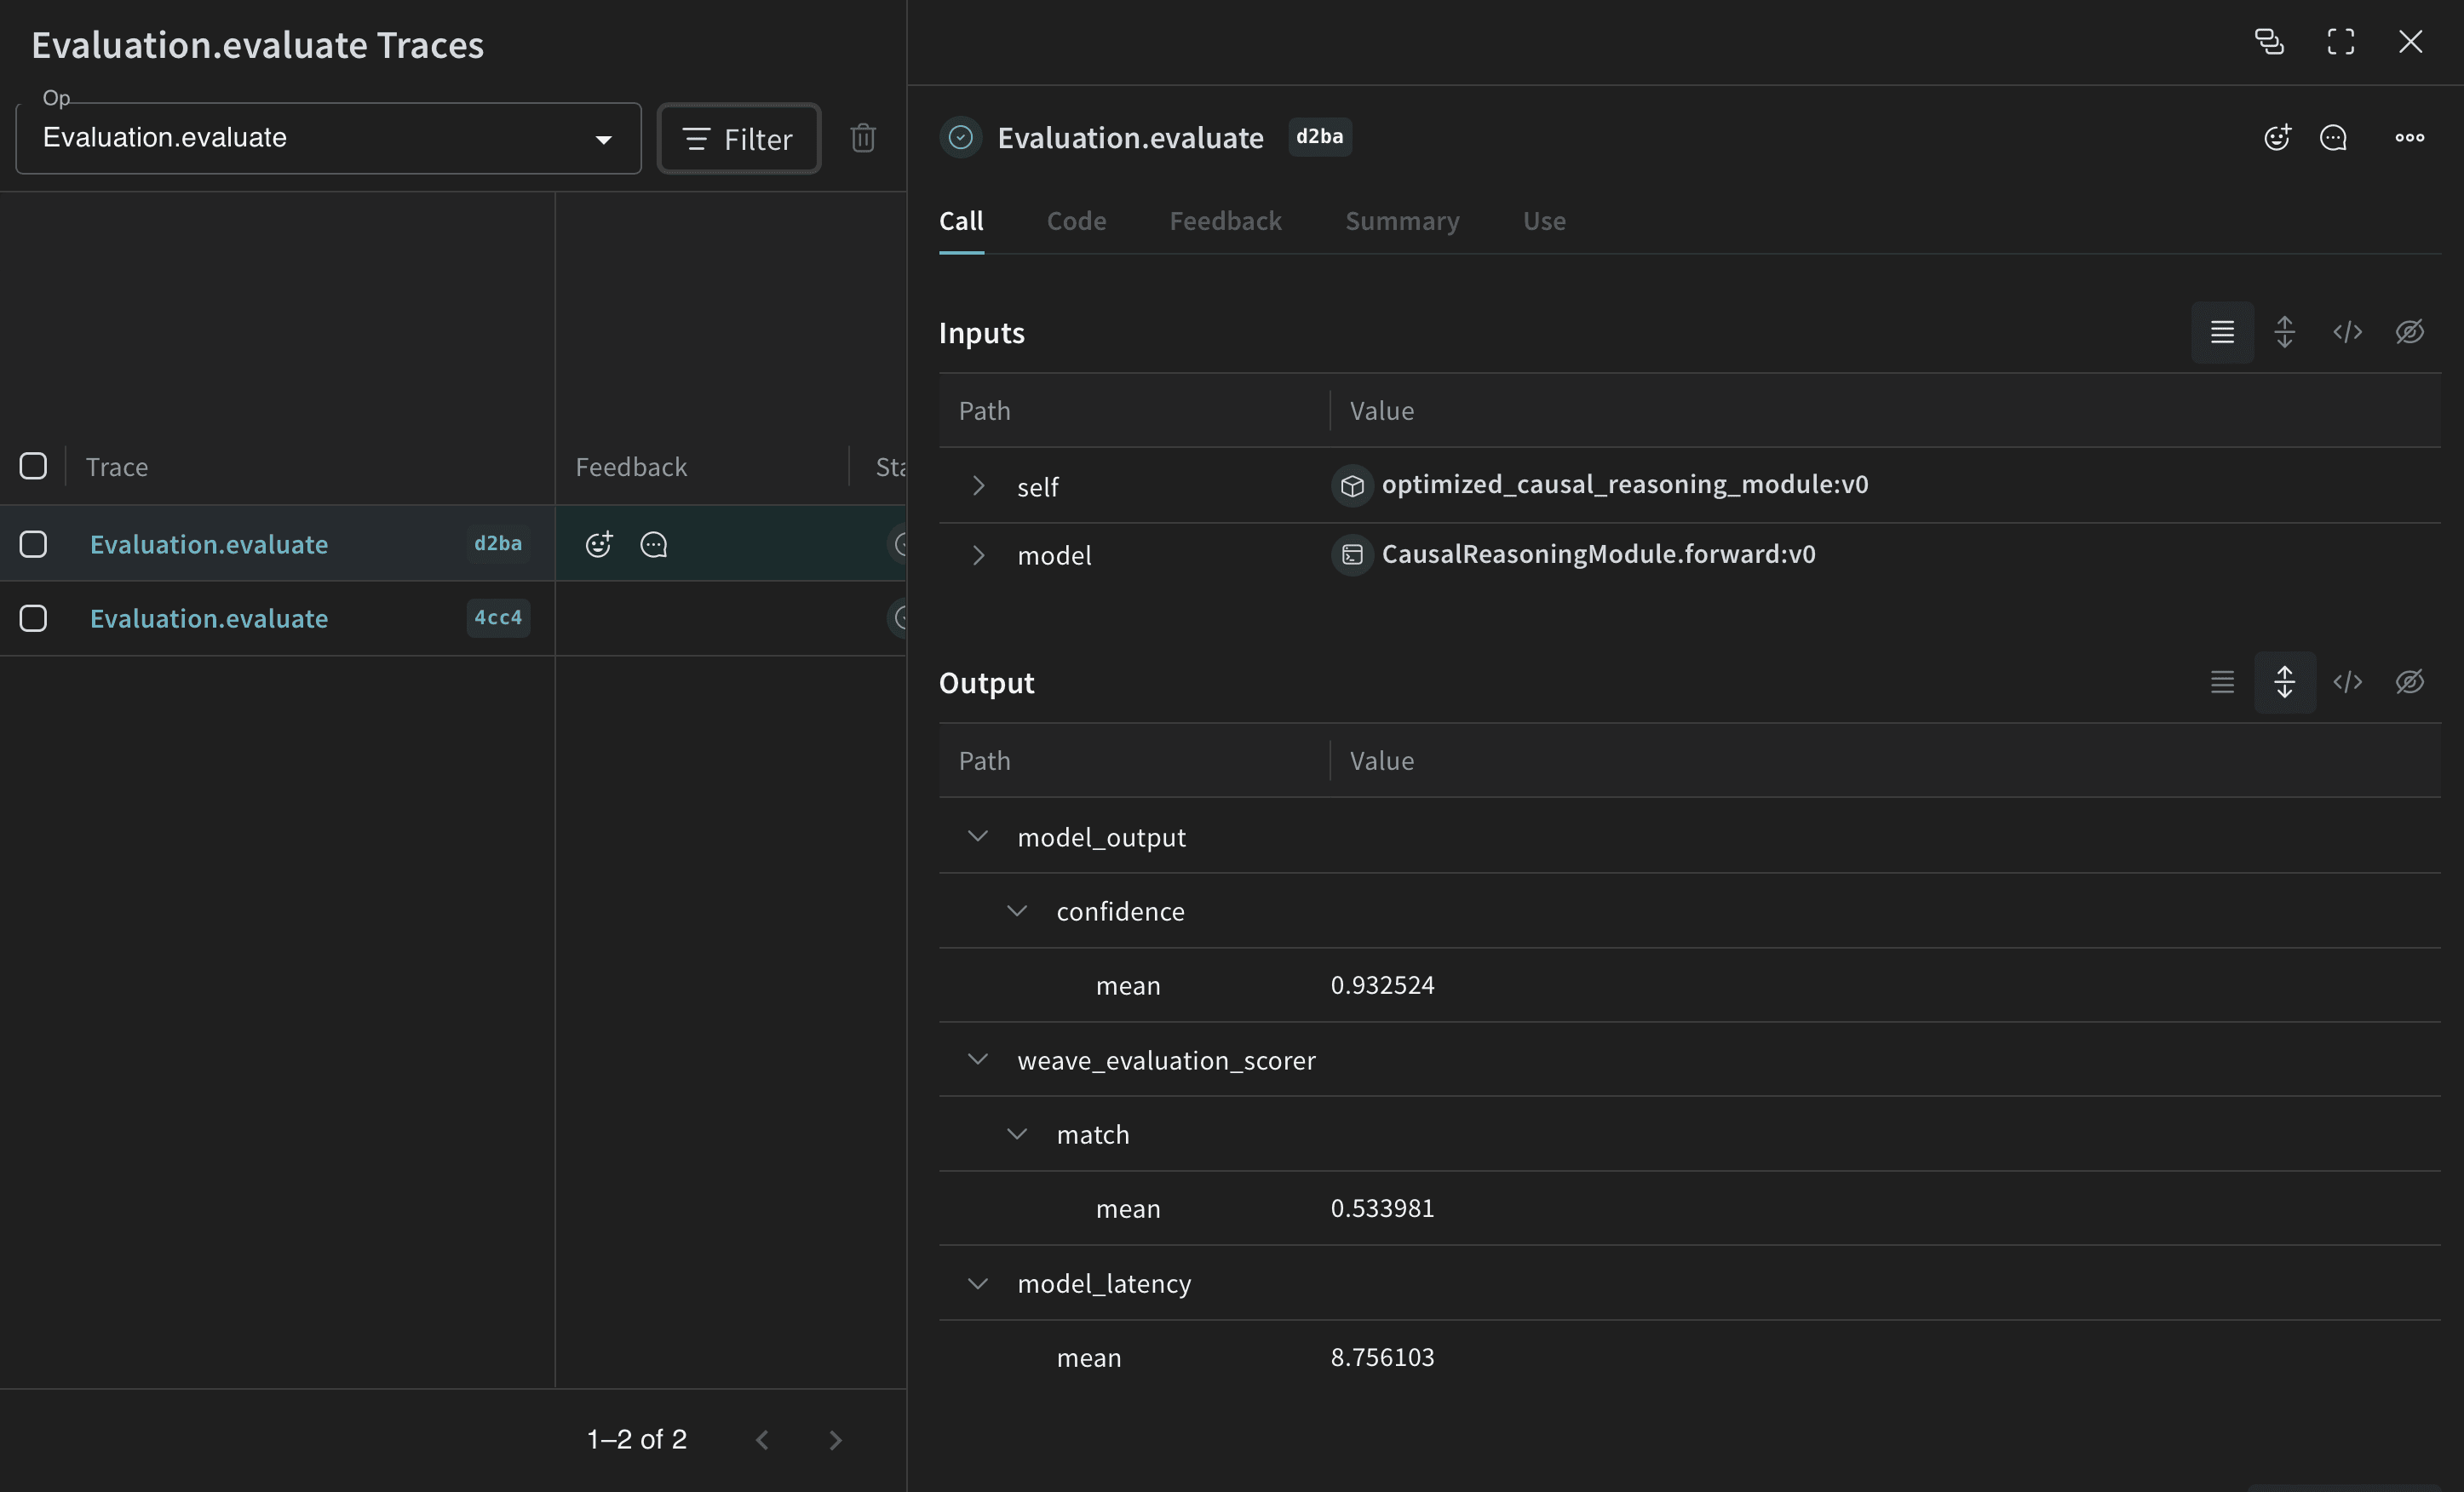
Maintenant que vous disposez d’une stratégie de prompting de référence, évaluez-la sur l’ensemble de validation à l’aide deweave.Evaluation, avec une métrique qui compare la réponse prédite à la réponse de référence. Weave prend chaque exemple, le fait passer dans votre application et attribue un score à la sortie à l’aide de plusieurs fonctions de score personnalisées. Cela vous donne une vue des performances de votre application, ainsi qu’une UI riche pour examiner en détail chaque sortie et son score.
Créez d’abord une fonction de score qui détermine si la réponse prédite correspond à la réponse de référence. Les fonctions de score Weave reçoivent la valeur de retour du modèle sous la forme de output, ainsi que toutes les clés correspondantes de l’exemple du jeu de données en arguments supplémentaires. Ici, answer provient du jeu de données et output est le dictionnaire renvoyé par CausalReasoningModule.forward.
weave.Evaluation peut appeler. Les noms des arguments de cette fonction d’encapsulation doivent correspondre aux noms des colonnes du jeu de données utilisées en entrée par le modèle.
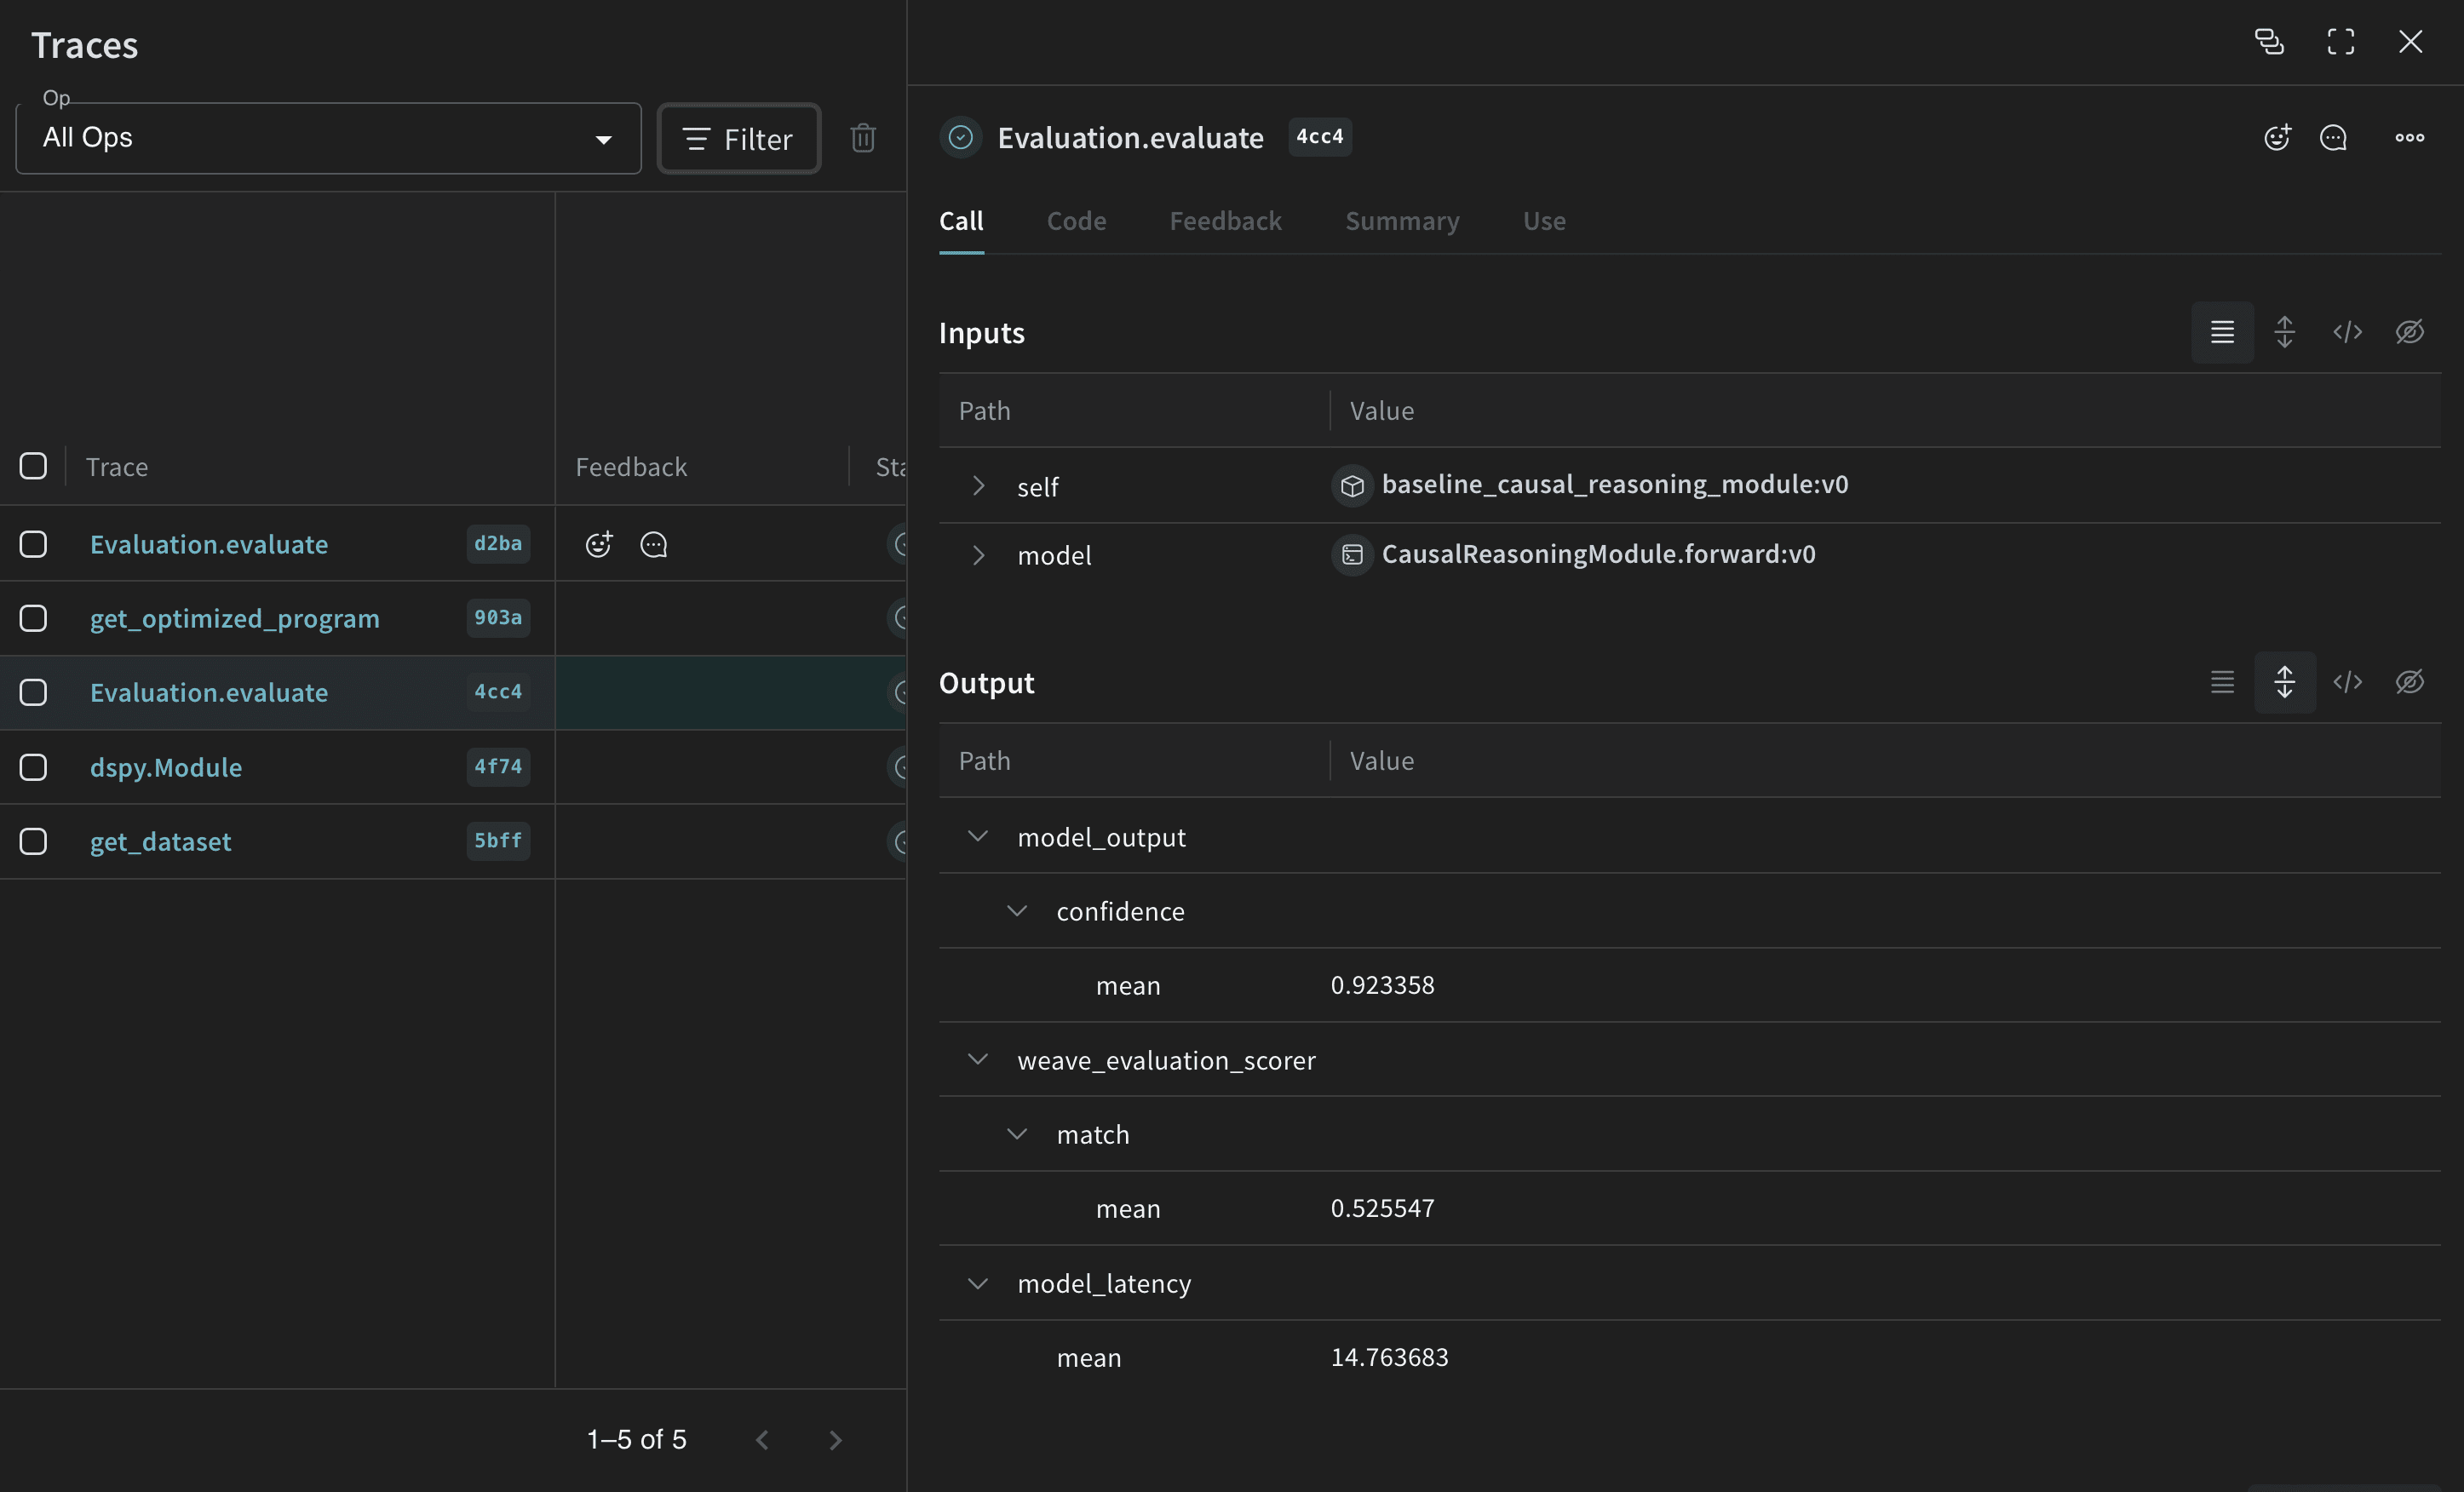
Si vous exécutez ce code depuis un script Python, vous pouvez utiliser le code suivant pour lancer l’évaluation :
Optimiser le programme DSPy
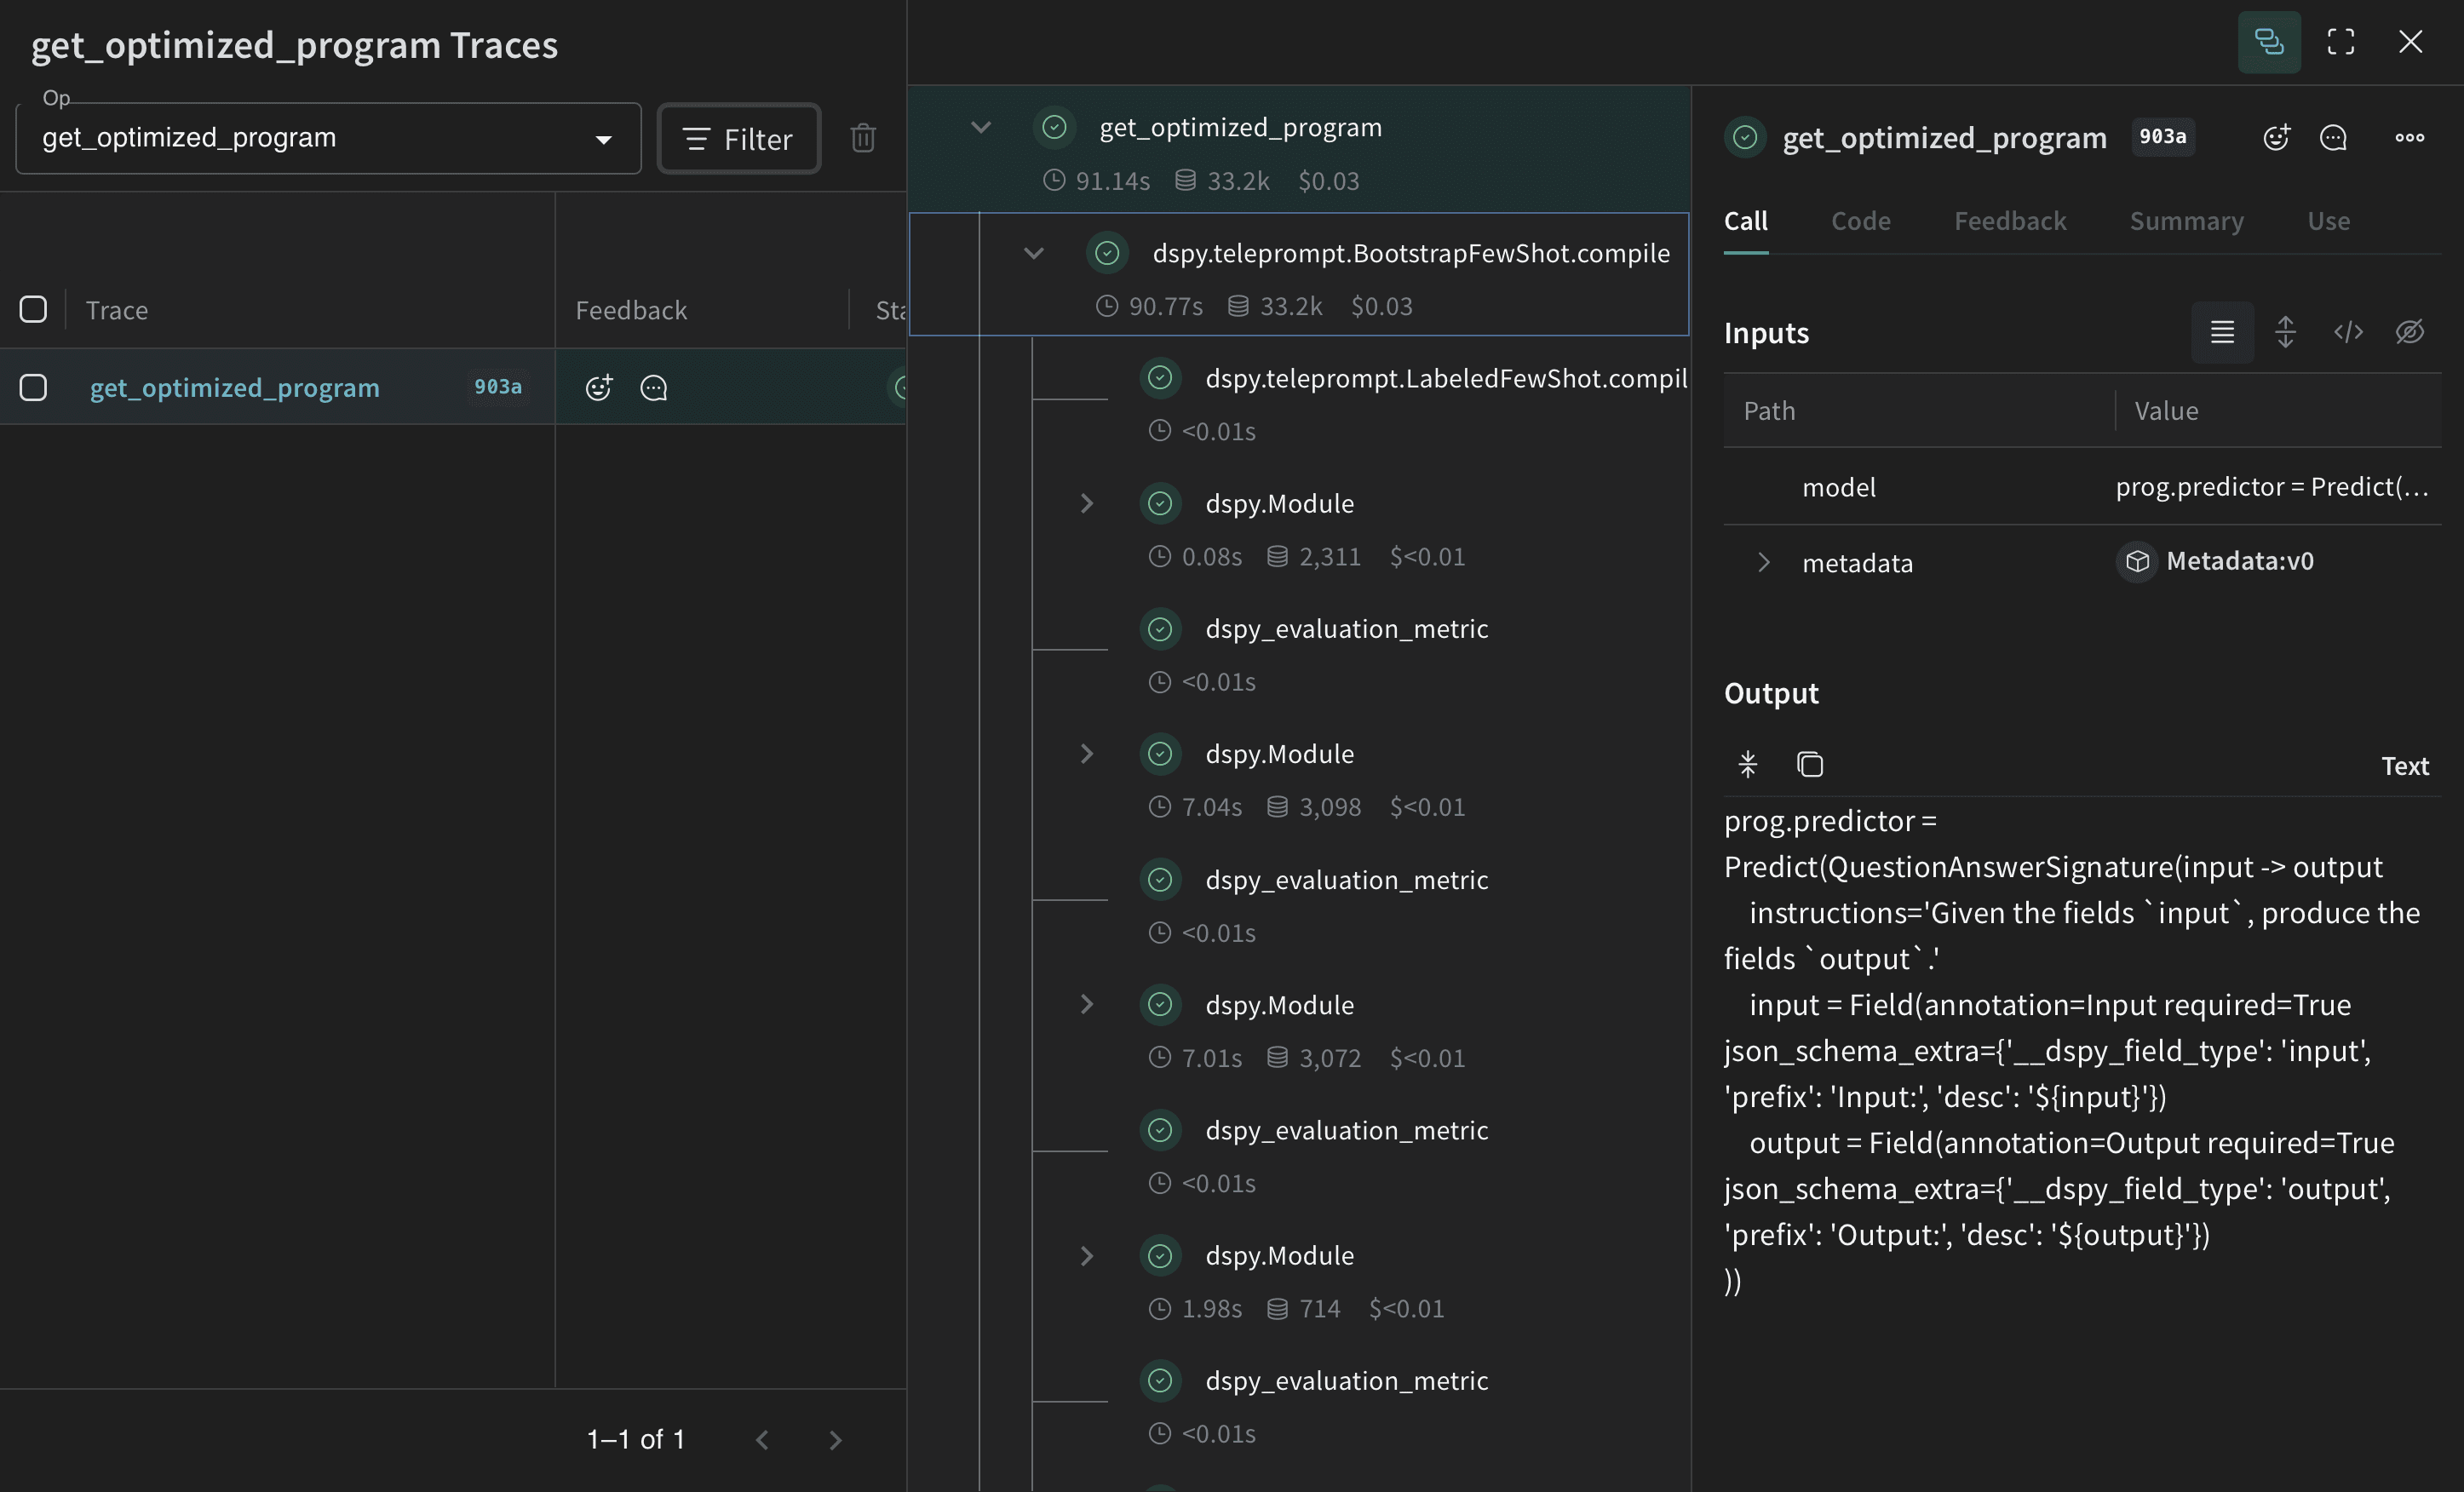
Une fois les performances de référence mesurées, vous pouvez maintenant appliquer un optimiseur DSPy et comparer le résultat à cette référence. Maintenant que vous disposez d’un programme DSPy de référence, améliorez ses performances en raisonnement causal à l’aide de l’optimiseur BootstrapFewShot, qui peut ajuster les paramètres d’un programme DSPy afin de maximiser les métriques spécifiées.