このノートブックで学ぶこと
このチュートリアルでは、W&B を PyTorch のトレーニングコードに統合して、実験をトラッキングし、メトリクスや勾配をログし、モデルをバージョン管理する方法を説明します。既存の PyTorch パイプラインに実験管理を追加する際に活用できます。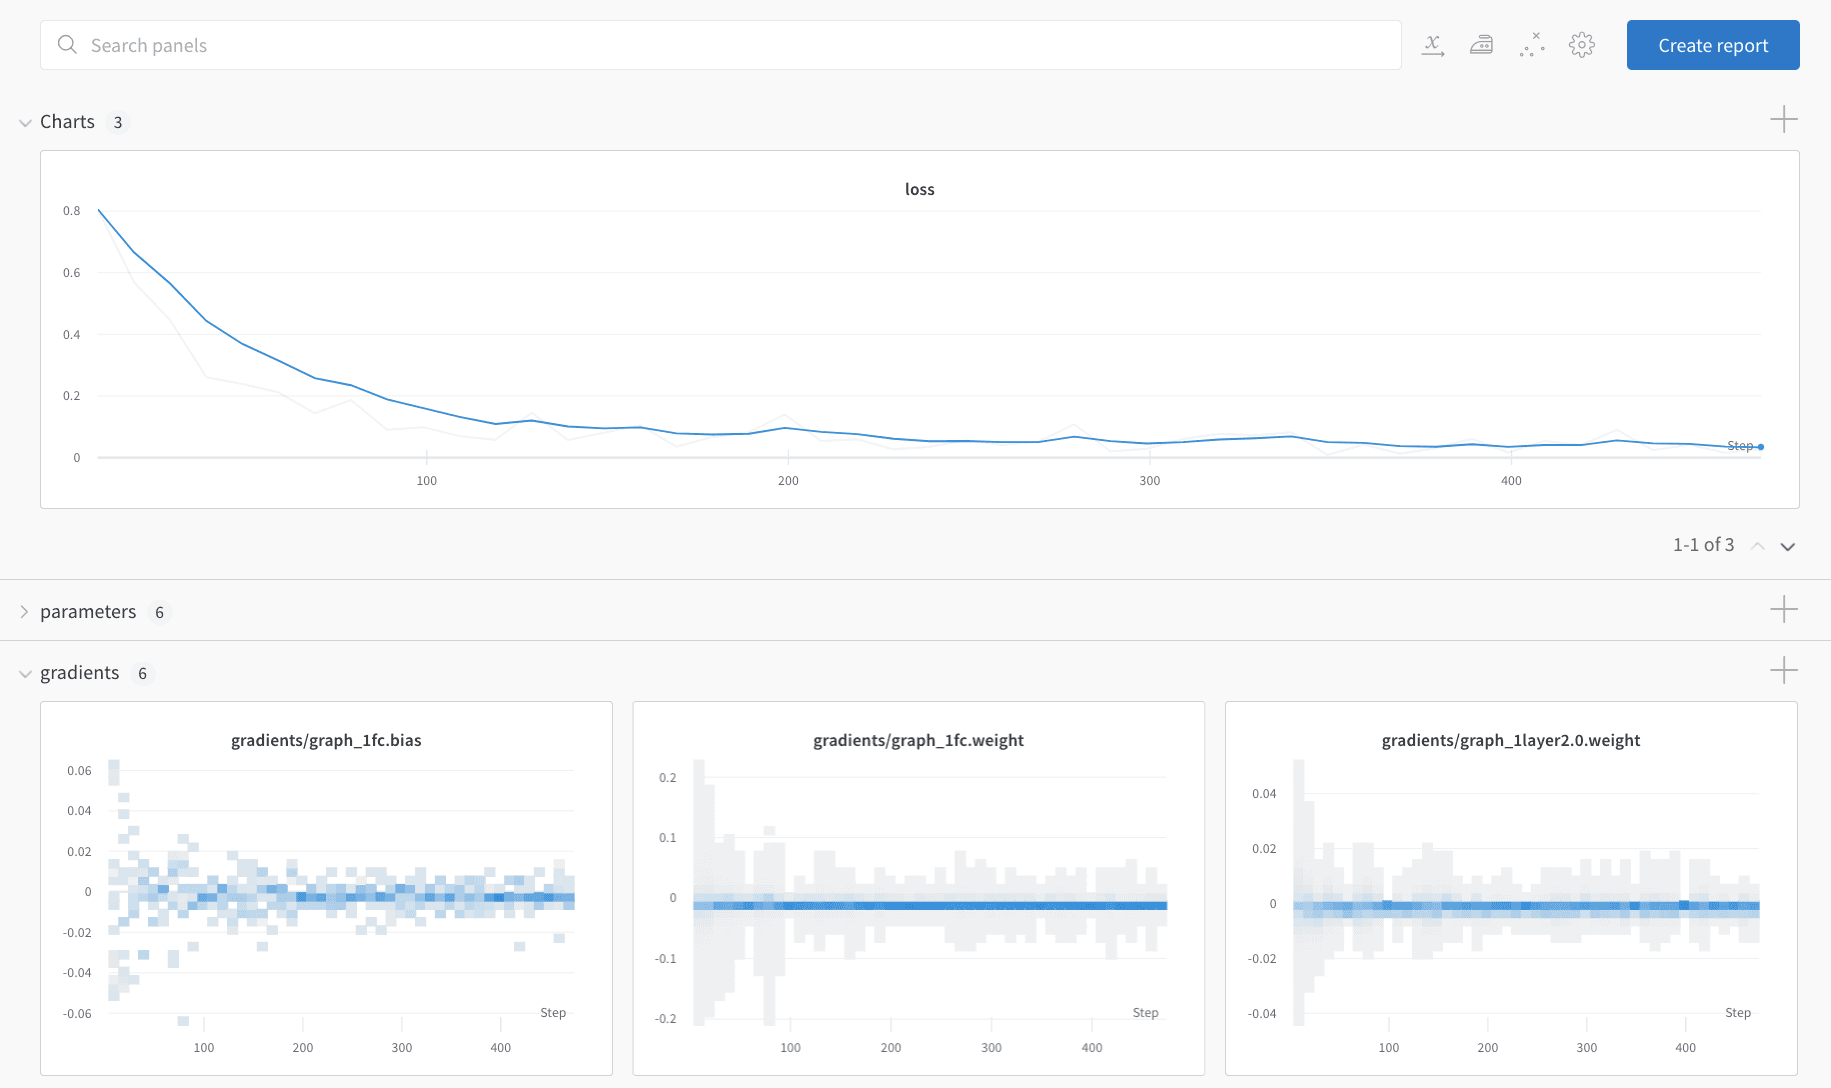
インストール、インポート、ログイン
実験を定義する前に、環境を設定し、W&B にログインします。Step 0: W&B をインストール
まずは、pip を使って wandb ライブラリをインストールする必要があります。
Step 1: W&B をインポートしてログイン
W&B のサービスにデータをログするには、ログインする必要があります。 W&B を初めて使用する場合は、表示されるリンクから無料アカウントにサインアップしてください。実験とパイプラインを定義する
W&B をインストールし、セッションの認証が完了したら、実験の設定と、その設定を使用するトレーニング パイプラインを定義します。wandb.init() でメタデータとハイパーパラメーターをトラッキングする
プログラム上では、まず実験を定義します。ハイパーパラメーターは何か、この run にはどのようなメタデータが関連付けられているのかを決めます。
この情報は config 辞書 (または同様のオブジェクト) に保存し、必要に応じて参照するのが一般的なワークフローです。
この例では、変化させるハイパーパラメーターはごく一部だけで、残りはコードに直接書いています。モデルのどの部分でも config に含めることができます。
この例には、MNIST データセットと畳み込みアーキテクチャに関するメタデータも含まれています。後で、たとえば同じプロジェクト内で CIFAR 上の全結合アーキテクチャを扱うことになった場合でも、このメタデータによって run を区別しやすくなります。
- モデルとそれに対応するデータ、オプティマイザを
makeします。 - 次にモデルを
trainします。 - 最後に
testし、トレーニングの結果を確認します。
wandb.init() のコンテキスト内で行われることです。
この関数を呼び出すと、
コードと W&B のサーバーの間の通信が確立されます。
config 辞書を wandb.init() に渡すと、
その情報はすぐにすべてログされるため、
実験で使用するよう設定した
ハイパーパラメーターの値をいつでも把握できます。
選択してログした値が常に実際にモデルで使われる値になるよう、
W&B ではオブジェクトの run.config コピーを使用することをおすすめします。
いくつか例を示すので、次の make の定義を確認してください。
パイプラインの定義ができたので、次のセクションではその各ステップ、つまりデータとモデルのセットアップ、トレーニング、テストを順に実装します。
補足: W&B ではコードを別プロセスで実行するようにしているため、W&B 側で問題が発生してもあなたのコードがクラッシュすることはありません。問題が解決したら、wandb sync を使ってデータをログできます。
データの読み込みとモデルを定義する
次に、データの読み込み方法と、モデルをどのように構成するかを指定します。 この部分は重要ですが、wandb を使わない場合と変わりません。
wandb を使っても変わらないため、この例では標準的な ConvNet アーキテクチャをそのまま使います。このコードを自由に試してみてください。結果はすべて wandb.ai にログされます。
トレーニングロジックを定義する
model_pipeline を進めていき、次は train をどのように行うかを指定します。ここで、トレーニングの進行に合わせて W&B インテグレーション が勾配、パラメーター、メトリクスをトラッキングします。
ここでは、wandb の 2 つの関数 watch と log を使います。
勾配は run.watch() でトラッキングし、それ以外はすべて run.log() でログする
run.watch() は、トレーニング中 log_freq step ごとに、モデルの勾配とパラメーターをログします。
トレーニングを始める前に run.watch() を呼び出してください。ログモード、複数のモデル、パフォーマンスのヒントについては、wandb.watch で勾配とモデルの重みをログするにはどうすればよいですか? を参照してください。
それ以外のトレーニングコードはそのままです。エポックとバッチを繰り返し処理し、フォワードパスとバックワードパスを実行して、optimizer を適用します。
run.log() に渡します。
run.log() には、キーが文字列の辞書を渡します。これらの文字列は、ログするオブジェクトを識別する名前で、対応する値がその内容になります。さらに、トレーニングのどの step にいるかを任意でログすることもできます。
補足: モデルがこれまでに見たサンプル数を使うと、バッチサイズが違っても比較しやすくなりますが、単純な step 数やバッチ数を使用してもかまいません。トレーニング run が長い場合は、epoch ごとにログするのも合理的です。
テスト方法を定義する
モデルのトレーニングが完了したら、テストを行います。 たとえば、本番環境の新しいデータで実行したり、 あるいは手作業で厳選したサンプルに適用したりします。テストは、トレーニング済みモデルを保存する自然なタイミングでもあります。任意: run.save() を呼び出す
ここで、モデルのアーキテクチャと最終的なパラメーターをディスクに保存しておくのもよいでしょう。幅広い互換性を確保するため、モデルは Open Neural Network eXchange (ONNX) 形式で export します。
そのファイル名を run.save() に渡すことで、モデルのパラメーターが W&B のサーバーにも保存されます。これで、どの .h5 や .pb がどのトレーニング runs に対応しているのか分からなくなることはありません。
モデルの保存、バージョン管理、配布に関する、より高度な wandb の機能については、Artifacts tools を参照してください。
トレーニングを実行し、wandb.ai でメトリクスをライブで確認する
ここまででパイプライン全体を定義し、数行の W&B コードを追加したので、完全にトラッキングされた experiment を実行する準備ができました。 W&B はいくつかのリンクを表示します。ドキュメント、Project ページ (project 内のすべての Runs を整理するページ) 、そして Run ページ (この run の結果が保存されるページ) です。 Run ページにアクセスして、次のタブを確認してください。- Charts。ここでは、モデルの勾配、パラメーターの値、損失がトレーニング全体を通してログされます。
- System。ここには、ディスク I/O 使用率や CPU、GPU のメトリクスなどのシステムメトリクスが表示されます。
- Logs。ここには、トレーニング中に標準出力に出力された内容のコピーがあります。
- Files。ここでは、トレーニング完了後に
model.onnxをクリックして、Netron model viewer でネットワークを表示できます。
with wandb.init() ブロックを抜けると、W&B は結果の概要もセル出力に表示します。
Sweeps でハイパーパラメーターを試す
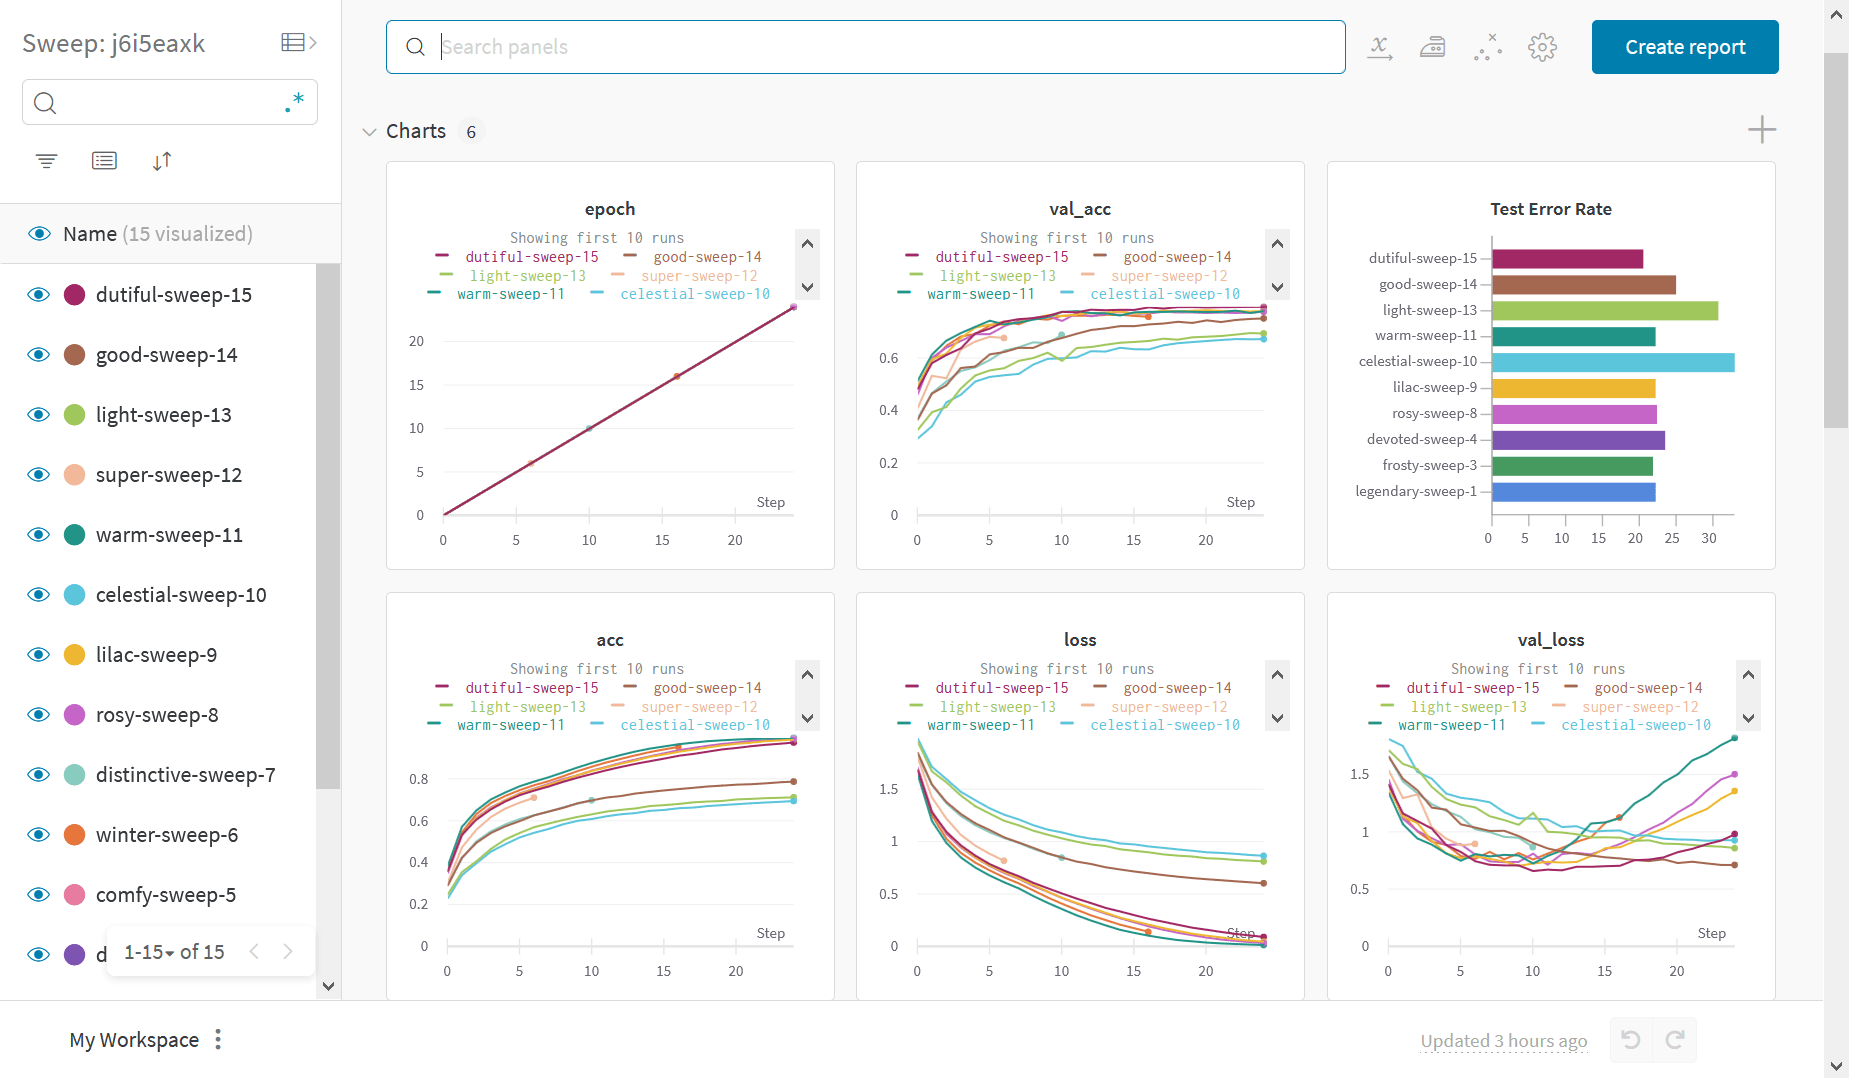
この例では、1 つのハイパーパラメーター設定だけを扱いました。多くの ML ワークフローでは、複数のハイパーパラメーターを変えながら試行を繰り返すことが重要です。 W&B Sweeps を使用すると、ハイパーパラメーターの検証を自動化し、考えられるモデルや最適化戦略の探索空間を調べることができます。これにより、前述の単一設定の run を超えてスケールできます。 W&B Sweeps を使用したハイパーパラメーター最適化を紹介する Colab ノートブックをご覧ください。 W&B でハイパーパラメーター sweep を実行するには、3 つのステップがあります。- sweep を定義する: 検索対象のパラメーター、検索戦略、最適化メトリクスなどを指定する辞書または YAML ファイル を作成します。
- sweep を初期化する:
sweep_id = wandb.sweep(sweep_config). - sweep エージェントを実行する:
wandb.agent(sweep_id, function=train).