これはインタラクティブなノートブックです。ローカルで実行するか、以下のリンクをご利用ください。
依存ライブラリのインストール
開始する前に、このチュートリアル全体で使用するライブラリをインストールしてください。このチュートリアルでは、次のライブラリを使用します。- DSPy:LLMワークフローの構築と最適化に使用します。
- Weave:LLMワークフローをトラッキングし、プロンプト戦略を評価するために使用します。
- datasets:HuggingFace Hub から BIG-Bench Hard データセットにアクセスするために使用します。
Weave を使ってトラッキングを有効にする
このセクションでは Weave を設定し、このチュートリアルで以降に行う DSPy の Call が自動的にトレースされ、Weave UI で確認できるようにします。 Weave は DSPy と統合されています。コードの先頭でweave.init を呼び出すと、DSPy の関数が自動的にトレースされ、その内容を Weave UI で確認できます。詳しくは、DSPy 向け Weave インテグレーションのドキュメント を参照してください。
weave.Object を継承したメタデータクラスを使用します。
BIG-Bench Hardデータセットを読み込む
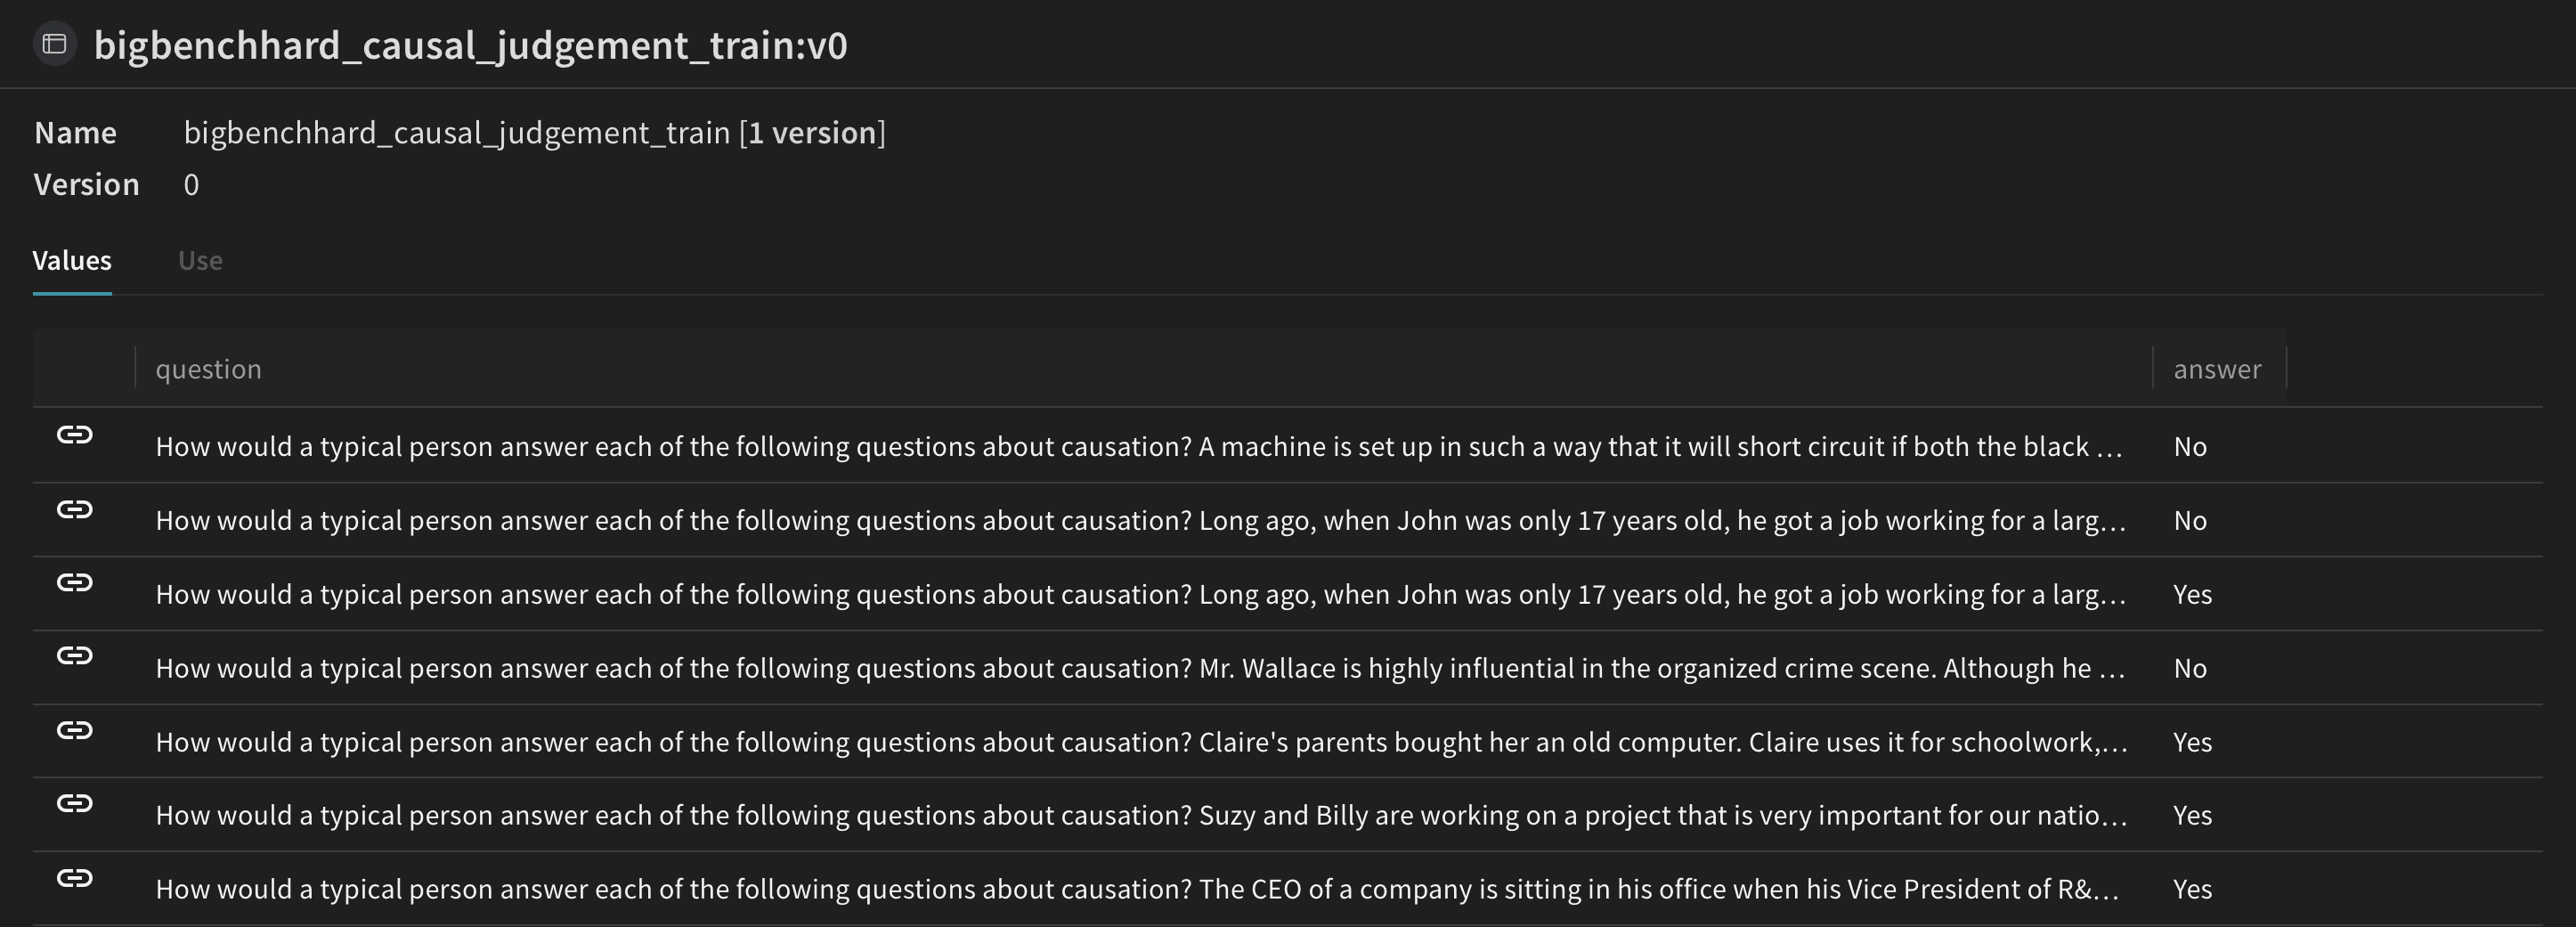
Weave tracking を有効にしたら、次のステップは、DSPyプログラムのトレーニングと評価に使用するデータを準備することです。 このデータセットをHuggingFace Hubから読み込み、トレーニング用セットと検証セットに分割したうえで、Weaveで公開します。公開すると、データセットをバージョン管理できるようになり、weave.Evaluationを使用してプロンプト戦略を評価することもできます。
DSPy プログラム
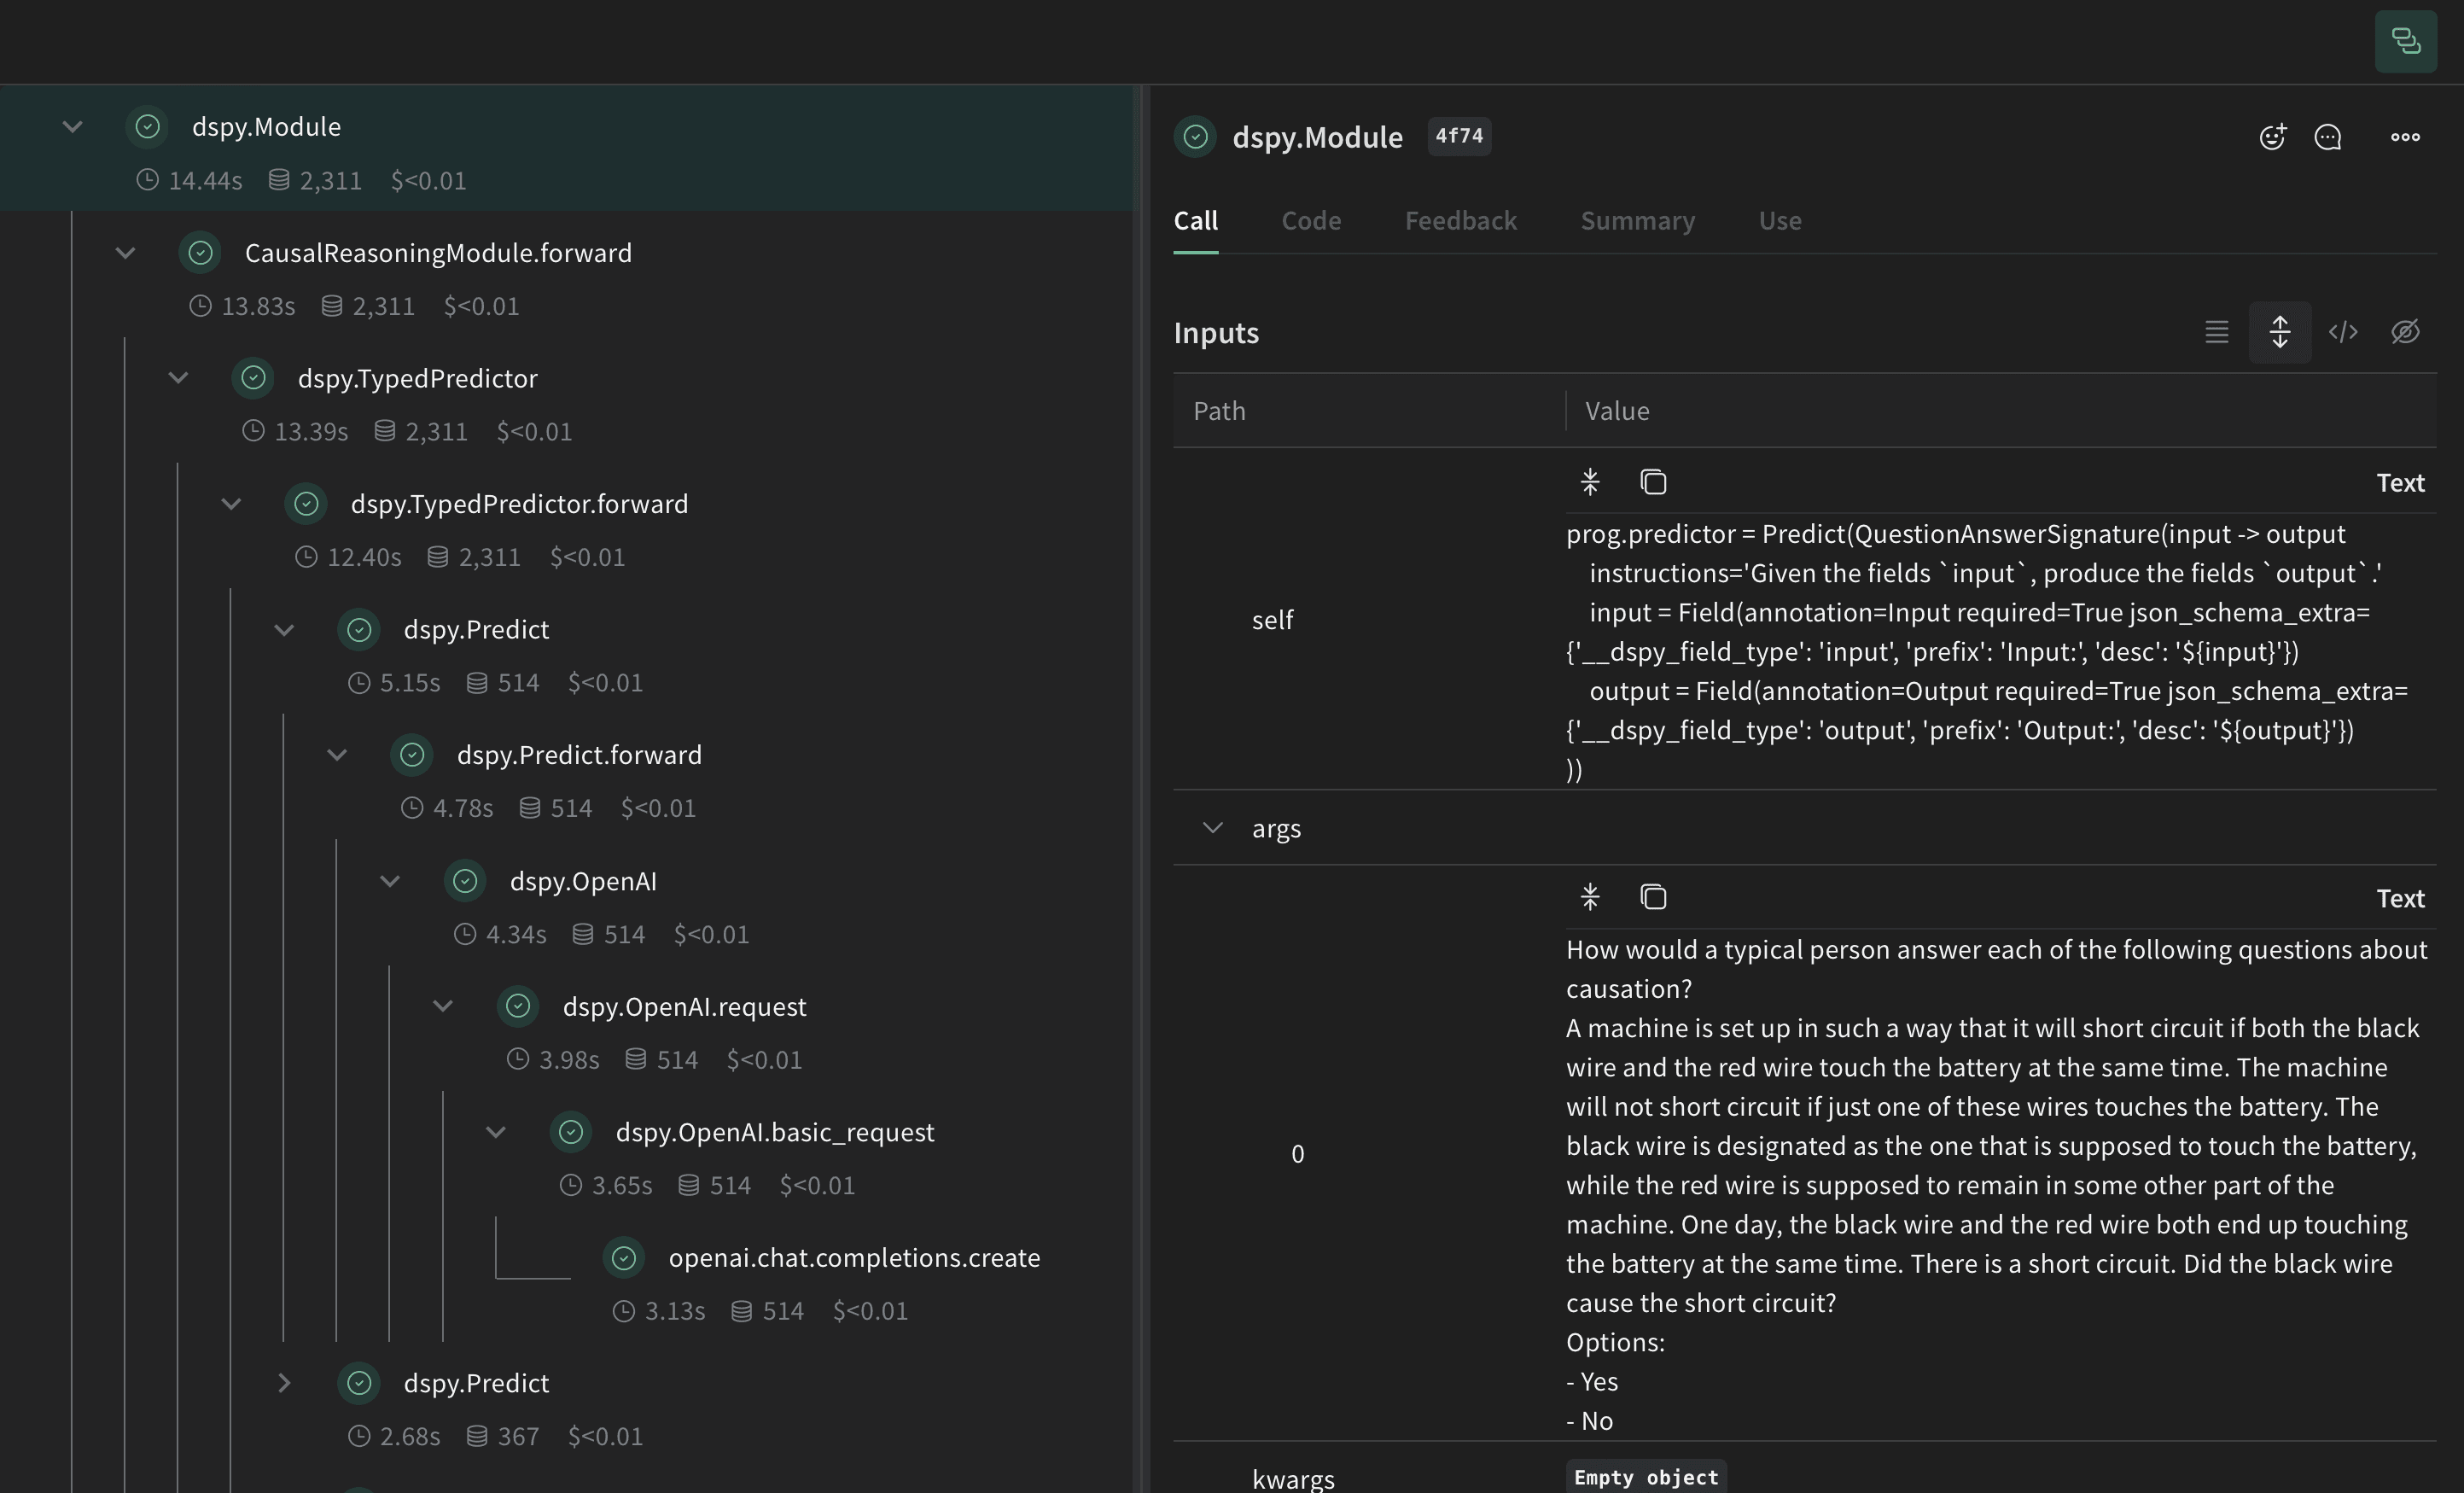
データセットを Weave に公開したので、次に、後で評価および最適化するベースラインの DSPy プログラムを定義できます。 DSPy は、新しい LM パイプラインの構築を、自由記述の文字列を操作するやり方から、プログラミング (モジュール化されたオペレーターを組み合わせてテキスト変換グラフを構成すること) へと近づけるフレームワークです。これにより、コンパイラがプログラムから最適化された LM 呼び出し戦略とプロンプトを自動生成します。 言語モデルの設定にはdspy.LM を使用し、それをデフォルトに設定するには dspy.configure を使用します。
因果推論シグネチャを作成する
signature とは、DSPy module の入出力の動作を宣言的に定義するものです。DSPy modules は、ニューラルネットワークの層に似たタスク適応型のコンポーネントで、特定のテキスト変換を抽象化します。CausalReasoningModule をテストします。
DSPy プログラムを評価する
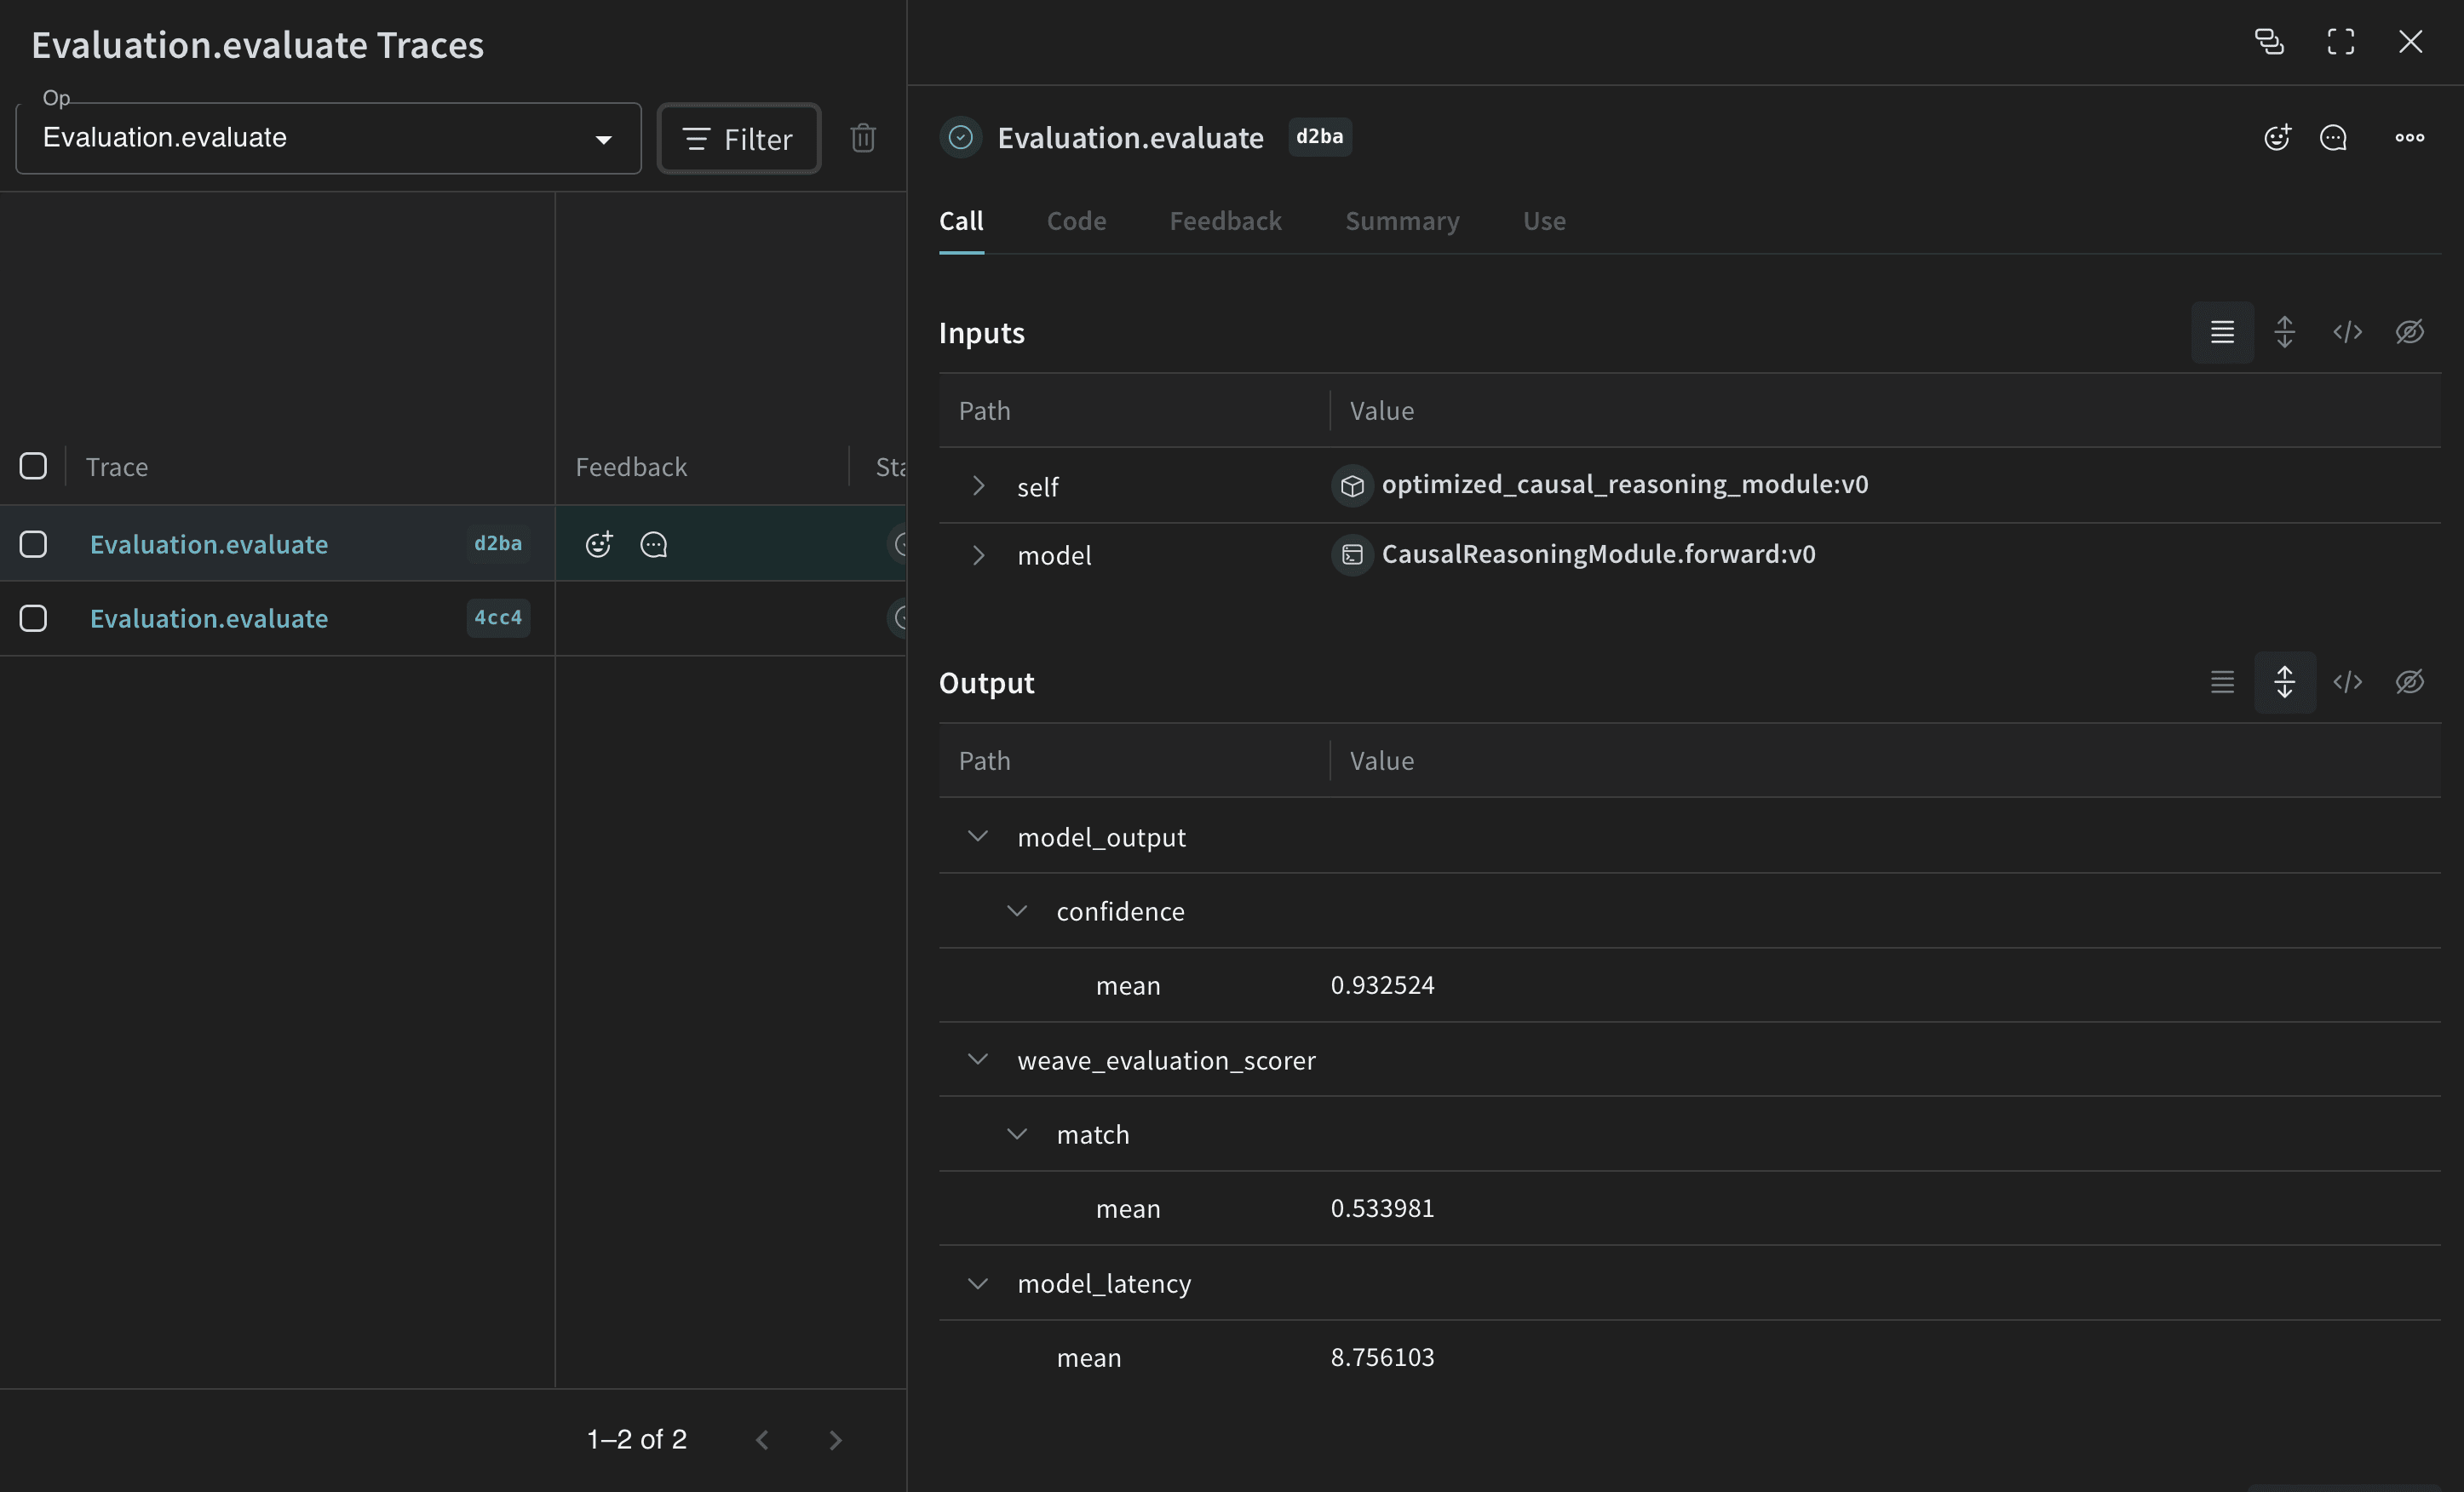
ベースラインのプロンプト戦略ができたので、予測した回答と正解を照合するメトリクスを使って、weave.Evaluation で検証セットを評価します。Weave は各例をアプリケーションに渡し、複数のカスタムスコアリング関数で出力を採点します。これにより、アプリケーションのパフォーマンスを把握できるほか、個々の出力やスコアを詳しく確認できる充実した UI も利用できます。
まず、予測した回答が正解と一致するかどうかを判定するスコアリング関数を作成します。Weave のスコアリング関数は、モデルの戻り値を output として受け取り、さらにデータセット例内の一致するキーを追加の引数として受け取ります。ここでは、answer はデータセットから取得され、output は CausalReasoningModule.forward が返す dict です。
weave.Evaluation から呼び出せるように、モジュールをトレース対象の関数でラップします。ラッパーの引数名は、モデルが受け取るデータセットの列名と一致している必要があります。
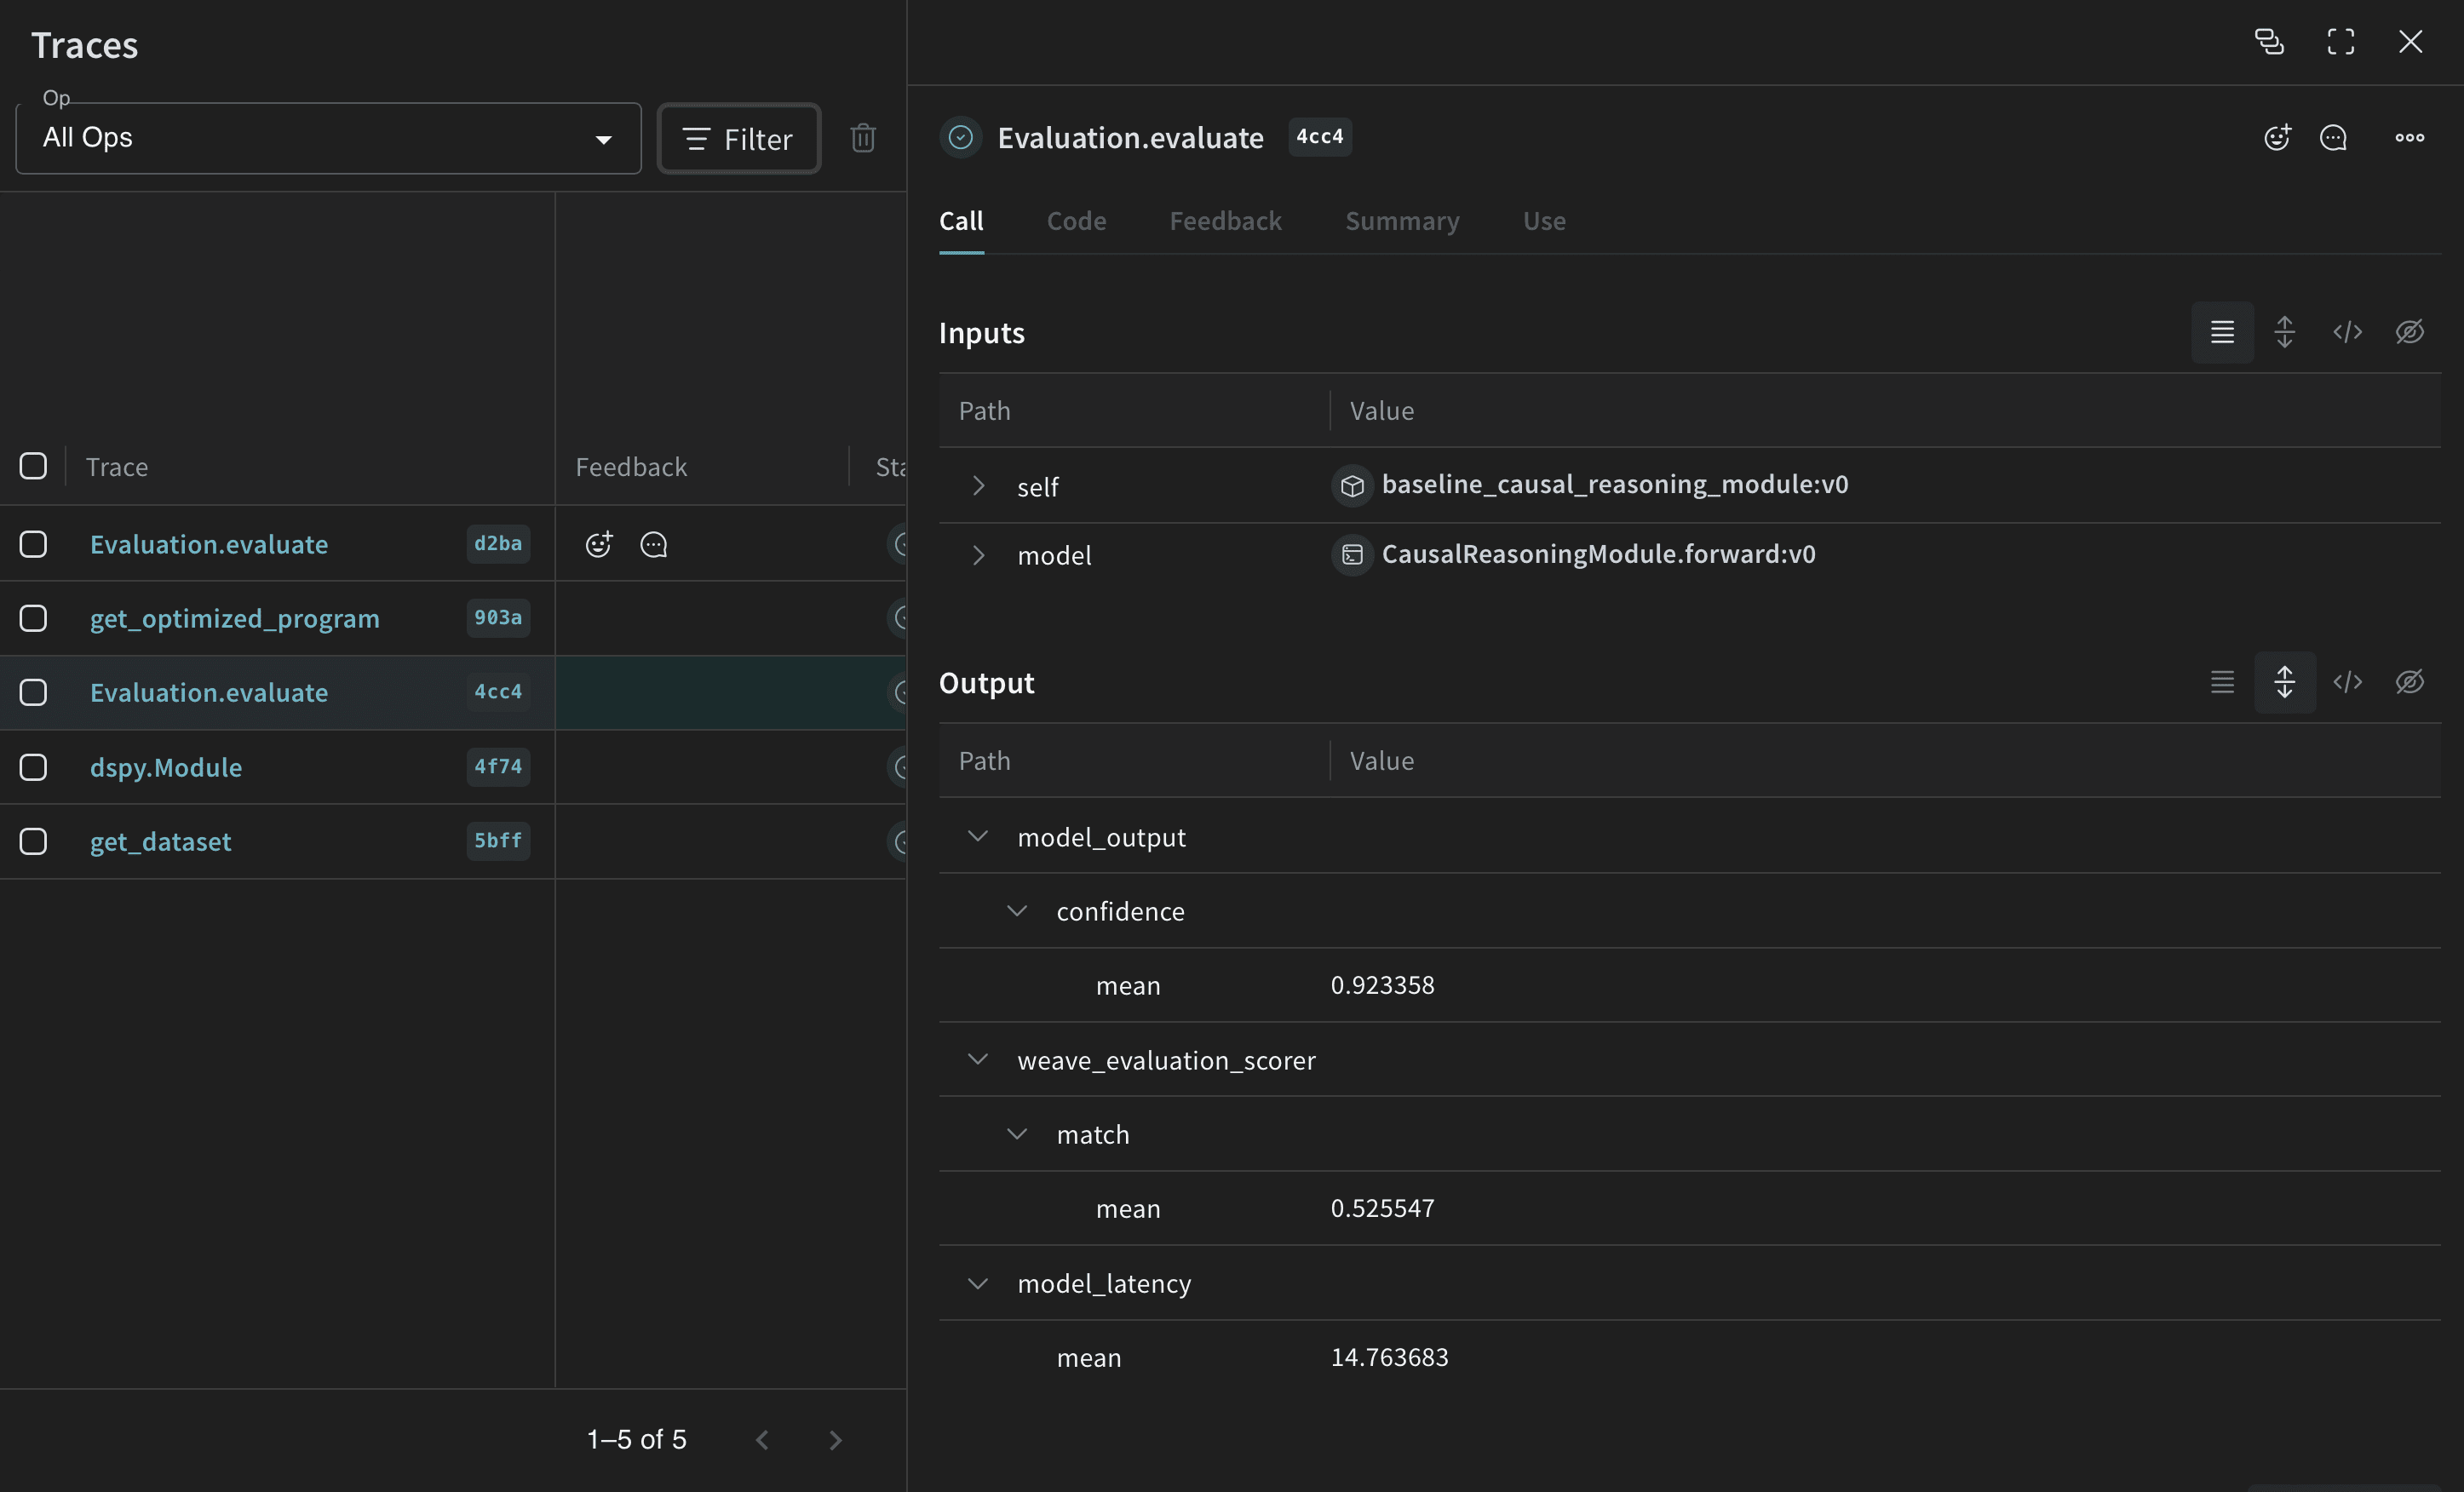
Python スクリプトから実行している場合は、次のコードを使用して評価を実行できます。
DSPy プログラムを最適化する
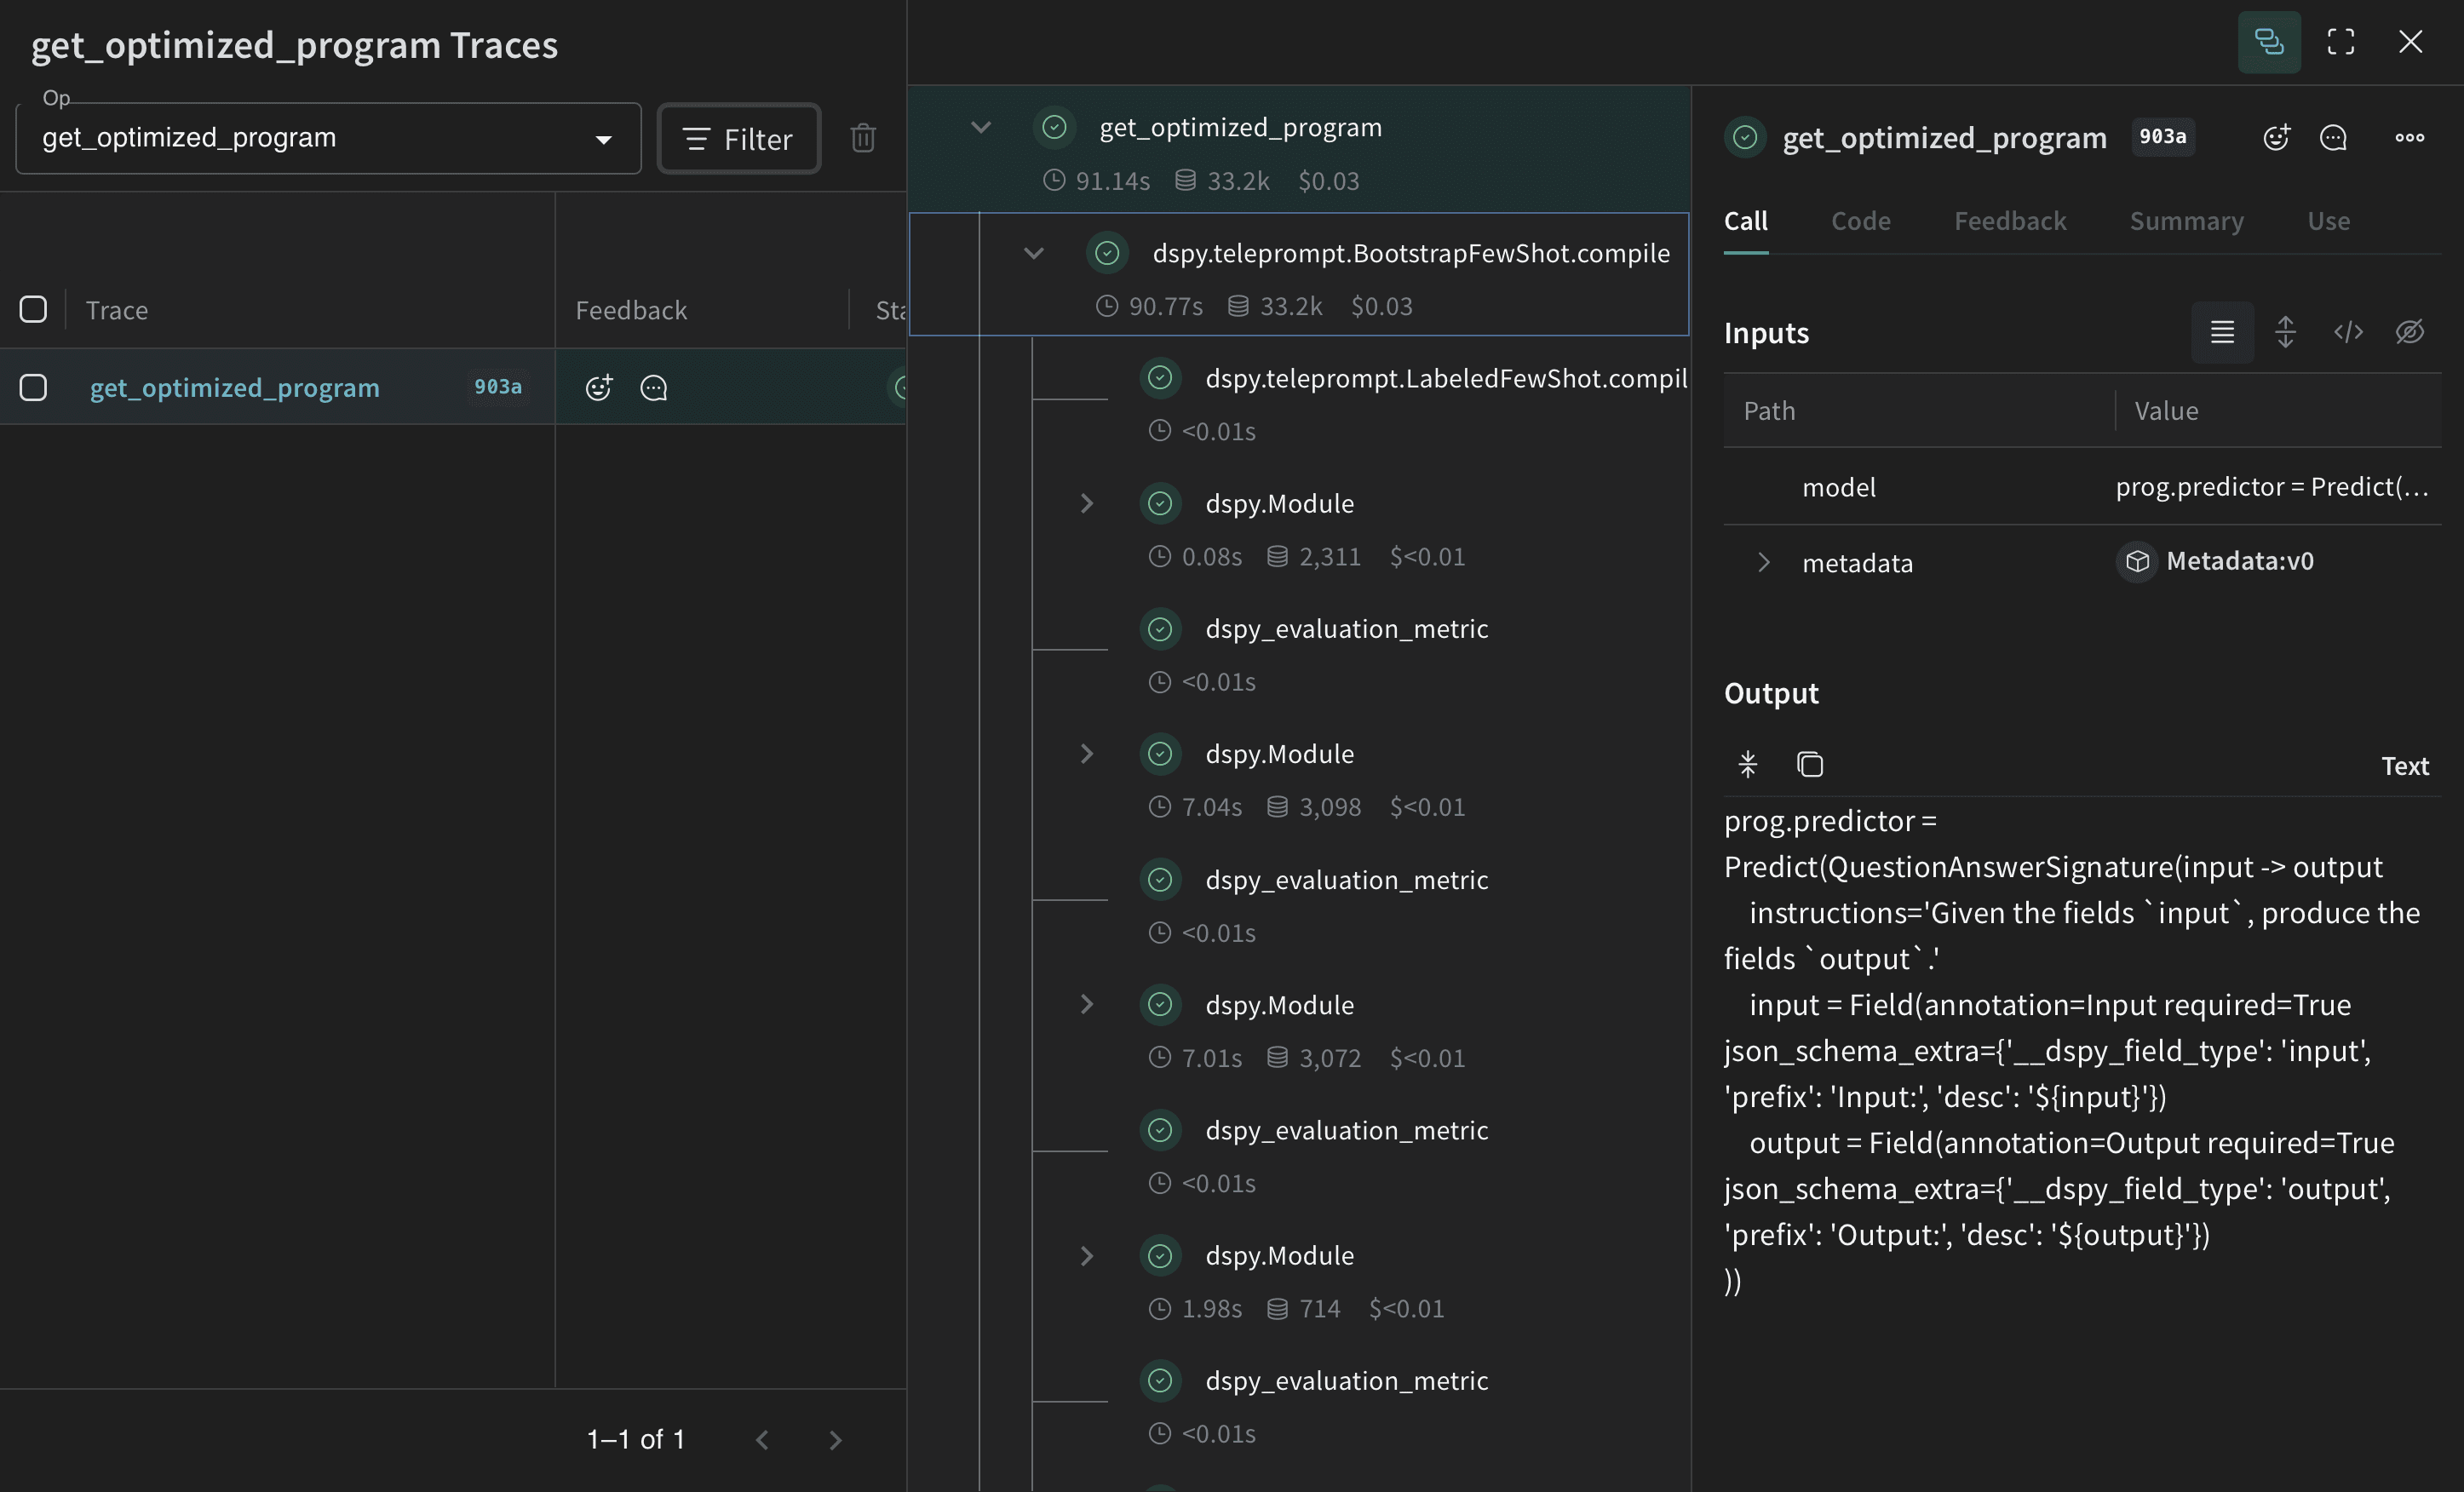
ベースラインのパフォーマンスを測定できたので、DSPy オプティマイザーを適用し、その結果をベースラインと比較できます。 これで DSPy プログラムのベースラインができたので、指定したメトリクスを最大化するように DSPy プログラムのパラメーターを調整できる BootstrapFewShot オプティマイザーを使って、因果推論のパフォーマンスをさらに向上させてみましょう。