

EvaluationLogger を使用して既存の Python または TypeScript のコードから予測とスコアを記録し、完全なデータセットや scorer 一式を最初に定義しなくても Weave でモデル性能を評価する方法を説明します。データセットや scorer を最初に定義していない場合、または workflow の実行中に評価データを段階的にログする必要がある場合は、この方法を使用してください。
あらかじめ定義した Dataset と Scorer オブジェクトの list が必要な標準の Evaluation オブジェクトとは異なり、EvaluationLogger では個々の予測とそれに関連するスコアを、利用可能になった時点で段階的にログできます。
より構造化された評価をご希望ですか?事前定義されたデータセットと scorer を備えた、より定型的な評価フレームワークを使用したい場合は、標準 Evaluation フレームワークを参照してください。
EvaluationLogger は柔軟性を重視している一方、標準フレームワークは構造とガイダンスを提供します。基本的なワークフロー
- ロガーを初期化する:
EvaluationLoggerのインスタンスを作成し、必要に応じてmodelとdatasetに関するメタデータを指定します。省略した場合、Weave はデフォルトを使用します。LLM Call (たとえば OpenAI) のトークン使用量とコストを記録するには、LLMを呼び出す前にEvaluationLoggerを初期化してください。 先にLLMを呼び出してから予測をログしても、Weave はトークンとコストのデータを取得しません。 - 予測をログする: システムの各入力/出力ペアに対して
log_prediction()を呼び出します。 - スコアをログする: 返された
ScoreLoggerを使用して、その予測に対するlog_score()を呼び出します。1つの予測に対して複数のスコアをログできます。 - 予測を完了する: 予測を確定するため、スコアをログしたら必ず
finish()を呼び出します。 - サマリーをログする: すべての予測の処理が完了したら、
log_summary()を呼び出してスコアを集計し、必要に応じてカスタムメトリクスを追加します。
log_example() を使用して手順 2~4 を 1 回の呼び出しにまとめることができます。
基本的な例
EvaluationLogger を使用して予測とスコアをログする方法を示しています。[YOUR-TEAM]/[YOUR-PROJECT] を W&B entity と project に置き換えてください。
- Python
- TypeScript
user_model 関数を定義し、入力のリストに適用します。各例について:- 入力と出力は
log_predictionを使用してログします。 - 正確性スコア (
correctness_score) はlog_scoreを使ってログします。 finish()はその予測のログ記録を完了します。
log_summary は集計メトリクスを記録し、Weave での自動スコア要約をトリガーします。log_example() を使用した簡易ログ記録
log_example() を使用すると、入力、1 つの出力、スコアを 1 回の Call でログできます。この便利なメソッドは、log_prediction()、log_score()、finish() を 1 つのステップにまとめたものです。バッチ評価やオフライン評価のように、ログする入力、モデル出力、スコアがすでにそろっている場合に便利です。
log_example() Call は、次と同等です:
Weave TypeScript SDK では
log_example() は使用できません。TypeScript ユーザーは、基本例 に示されている logPrediction() と logScore() のパターンを使用してください。高度な使い方
EvaluationLogger は、基本的なワークフローを超えて、より複雑な評価シナリオに対応できる柔軟なパターンを提供します。以下のセクションでは、コンテキストマネージャーを使った自動的なリソース管理、エージェントのトレースと評価行のリンク、モデル実行とログすることの分離、リッチメディアデータの活用、複数のモデル評価の比較表示などの高度な手法を紹介します。
コンテキストマネージャーを使用する
EvaluationLogger は、予測とスコアの両方でコンテキストマネージャー (with 文) をサポートしています。これにより、コードをより簡潔に保ち、リソースを自動的にクリーンアップし、LLM judge Call のようなネストされた操作をより適切にトラッキングできます。
このコンテキストで with 文を使用する主な利点は次のとおりです。
- コンテキストを抜ける際に
finish()が自動的に呼び出される。 - ネストされた LLM Call の token と cost の tracking が向上する。
- 予測コンテキスト内で、モデル実行後に output を設定できる。
- Python
- TypeScript
エージェント トレースを評価にリンクする
log_prediction() コンテキスト内で実行します。EvaluationLogger は、そのコンテキスト内で作成されたスパンに評価 run、例、試行のメタデータを設定します。Weave はこのメタデータを使用して、トレースを評価結果にリンクします。
評価とエージェント スパンの自動リンクは Python でのみ利用できます。TypeScript の
EvaluationLogger と Evaluation.evaluate() は、エージェント スパンにリンクするアクティブな評価スコープを作成しません。TypeScript では、このセクションで説明する OTel 属性をスパンに直接設定することでのみリンクできます。また、両方の Call ID がすでに利用可能である必要があります。[YOUR-TEAM]/[YOUR-PROJECT] は、W&B の entity と project に置き換えてください。
- Python
- TypeScript
log_prediction() コンテキスト内で実行され、Weave インテグレーションによってトレースされる場合、Weave はトレースを評価結果に自動的にリンクします。それ以外の場合は、エージェント スパンに 2 つのリンク用 ID を自分で設定します。設定方法は、スパンが作成される場所によって異なります。
- 同じプロセス内で独自にインストルメンテーションする場合: 各スパンに属性を直接設定します。
- 別のサービスの場合: 両方の ID をそのサービスに送信し、そのサービスが作成するスパンに設定します。
自分でインストルメントしたスパンをリンクする
log_prediction() コンテキスト内でスパンが作成された場合、EvaluationLogger はすべての属性を自動的に設定します。ただし、独自の OpenTelemetry (OTel) インストルメンテーションでスパンを送信する場合は、リンクする各スパンに属性を直接設定する必要があります。評価では、次の属性を設定できます。
/agents/otel/v1/traces エンドポイントを通じて、評価と同じ Weave プロジェクトにスパンを送信します。OTel スパン属性は親スパンから子スパンに伝播しないため、リンクするすべてのスパンに属性を設定してください。
エンドポイントの詳細については、次を参照してください。
- 既存の OTel パイプラインからスパンを送信する方法については、OpenTelemetry スパンを Agents ビューに送信するを参照してください。
- エンドポイントの仕様については、GenAI トレースをエクスポートするを参照してください。
weave.eval.run_id と weave.eval.predict_and_score_call_id のみです。行ダイジェスト、例 ID、試行インデックス、kind、評価名はコンテキストの追加やフィルタリングに使用できますが、それ自体ではリンクを作成しません。2 つのリンク属性には、OTel のトレース ID やスパン ID ではなく、Weave Call ID を使用してください。
両方の ID は、評価結果クエリ APIから取得できます。レスポンスの各評価には evaluation_call_id があり、各試行には predict_and_score_call_id があります。
次の例では、span がエージェント操作の OTel スパンであることを前提としています。各角括弧内の値を、スパンが属する評価 run と結果のメタデータに置き換えてください。
TypeScript の例では、予測スコープに依存せず、OTel 属性を直接設定します。両方の Call ID をすでに取得している場合にのみ使用してください。
- Python
- TypeScript
別のサービスで実行されるエージェントをリンクする
EvaluationLogger パターンは Python でのみ使用できます。
- Python
- TypeScript
log_prediction() のコンテキストに入ると、コンテキスト本体の実行前に Evaluation.predict_and_score Call が作成されます。このコンテキストは、両方の Call ID を公開する ScoreLogger (次の例では prediction にバインド) を返します。同じ評価結果にサービスの出力とスコアをログできるよう、サービスから応答が返るまでコンテキストを開いたままにします。評価プロセスで、[AGENT-SERVICE-URL] をエージェントを実行するエンドポイントに置き換え、[YOUR-TEAM]/[YOUR-PROJECT] も置き換えます。[YOUR-TEAM]/[YOUR-PROJECT] にスパンをエクスポートするようサービスを設定します。eval_context をコピーします。OTel はラッパースパンからスパン属性を継承しません。評価からリンクされたエージェント スパンを表示する
- wandb.ai にアクセスします。
- Weave のサイドバーメニューで Evals をクリックします。
- 評価 run を選択します。
- 開いた評価の詳細パネルで、Evaluation タブの View spans をクリックします。Agents ページが開き、Spans タブにはその評価でフィルターされたスパンが表示されます。
既存のデータセットにリンクする
生のデータセットをlog_prediction に inputs として渡すと、Weave は評価の run ごとにデータを再インポートします。そのため重複データが保存され、データセットが大きい場合や、多数の評価で再利用する場合には容量の無駄になることがあります。
この重複を避けるには、評価を実行する前にデータセットを Weave に公開し、その公開済みデータセットの行を inputs として渡してください。Weave はデータを再インポートする代わりに、公開済みの行への参照を内部参照として解決します。これにより、標準の Evaluation フレームワークと同様に、各予測が Weave UI 内の特定のデータセット行にリンクされるようになります。
次の例では、データセットを公開して EvaluationLogger でそれにリンクし、他のデータセットと同様に取得して反復処理します。
- Python
- TypeScript
ログする前に出力を取得する
- Python
- TypeScript
リッチメディアをログする
log_prediction または log_score メソッドに dict またはメディアオブジェクトを渡すだけです。
- Python
- TypeScript
複数の評価をログして比較する
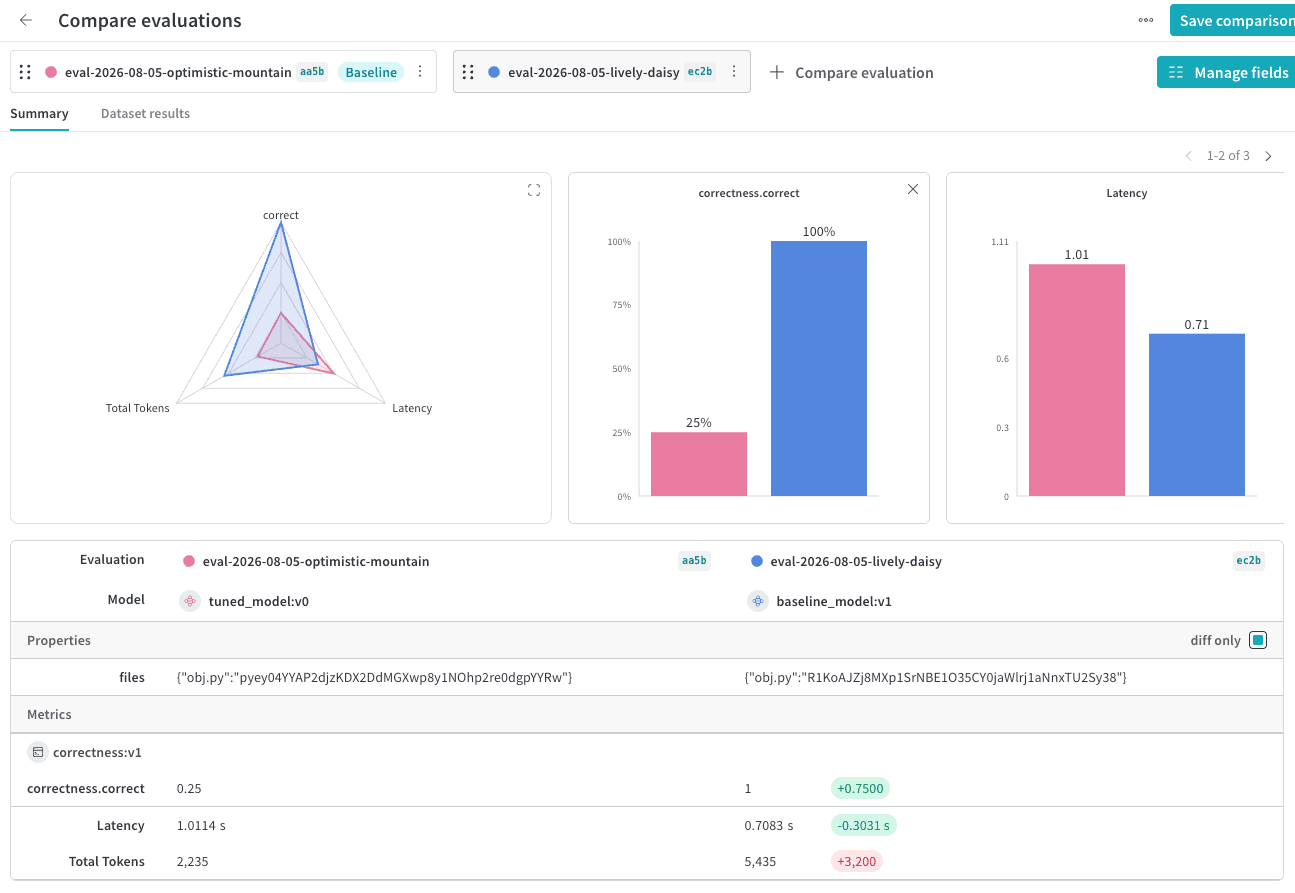
EvaluationLogger を使用すると、複数の評価をログして Weave UI で並べて比較できます。これは、同じデータセットに対して異なるモデルがどのように機能するかを評価する際に役立ちます。
- 以下のコードサンプルを実行します。
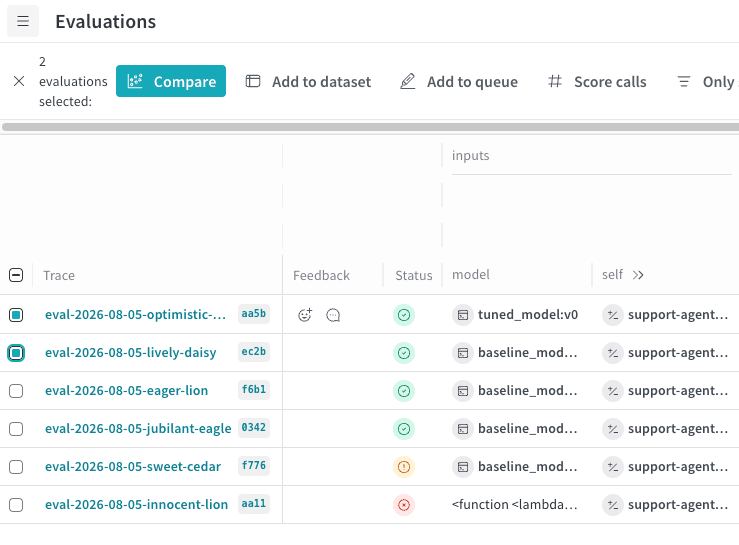
- Weave UI で Evals タブを開きます。
- 比較したい評価を選択します。
- Compare をクリックします。Compare ビューでは、次のことができます。
- 追加または削除する評価を選択する。
- 表示または非表示にするメトリクスを選択する。
- 特定の例をページで切り替えながら、同じデータセット内の同じ入力に対して各モデルがどのような結果を返したかを確認する。
- Python
- TypeScript
使用上のヒント
EvaluationLogger を最大限に活用するのに役立ちます。
- Python
- TypeScript
- 各予測の後は、すぐに
finish()を呼び出してください。 log_summaryを使用して、個々の予測に紐づかないメトリクス (たとえば、全体のレイテンシ) を記録します。- リッチメディアのログ記録は、定性的な分析に最適です。