

W&B를 사용하는 이유
- 통합 대시보드: 모든 모델 메트릭과 예측을 한곳에서 관리할 수 있습니다.
- 경량: Hugging Face와 통합하는 데 코드 변경이 필요하지 않습니다.
- 접근성: 개인과 학술 팀은 무료로 사용할 수 있습니다.
- 보안: 모든 프로젝트는 기본적으로 비공개입니다.
- 신뢰성: OpenAI, Toyota, Lyft 등 여러 머신 러닝 팀에서 사용합니다.
설치, 임포트 및 로그인
이 섹션에서는 튜토리얼을 실행하는 데 필요한 환경을 설정합니다. Hugging Face 및 W&B 라이브러리를 설치하고, 이 튜토리얼에 필요한 GLUE 데이터셋과 트레이닝 스크립트를 다운로드하세요:- Hugging Face Transformers: 자연어 모델 및 데이터셋.
- W&B: 실험 추적 및 시각화.
- GLUE dataset: 언어 이해 벤치마크 데이터셋.
- GLUE script: 시퀀스 분류용 모델 트레이닝 스크립트.
API 키 추가
API 키로 인증하면 이 노트북이 W&B 계정에 연결되어 Runs가 프로젝트에 로깅됩니다. 가입한 후 다음 셀을 실행하고 링크를 클릭해 API 키를 조회한 다음 이 노트북을 인증하세요.WANDB_WATCH=all로 설정하면 그라디언트와 파라미터를 모두 기록할 수 있습니다. 전체 옵션 목록은 Hugging Face 인테그레이션 가이드를 참조하세요.
모델 학습
환경 구성을 완료하고 인증도 마쳤다면, 이제 트레이닝 run을 시작할 준비가 되었습니다. 다운로드한 트레이닝 스크립트run_glue.py를 실행하면 학습 과정이 자동으로 W&B 대시보드에 기록되는 것을 확인할 수 있습니다. 이 스크립트는 BERT를 Microsoft Research Paraphrase Corpus(두 문장이 의미적으로 동등한지 여부를 사람이 주석으로 표시해 둔 문장 쌍 데이터셋)로 파인튜닝합니다.
대시보드에서 결과 시각화하기
트레이닝이 시작되면 메트릭을 실시간으로 모니터링할 수 있습니다. 이전 셀에서 출력된 링크를 클릭하거나 wandb.ai로 이동해 실시간으로 스트리밍되는 결과를 확인하세요. 브라우저에서 run을 확인할 수 있는 링크는 모든 의존성이 로드된 다음에 표시됩니다. 다음과 같은 출력을 찾으세요: “wandb: View run at [URL to your unique run]”모델 성능 시각화
실험 전반을 한눈에 살펴보고, 결과를 확대해서 확인하며, 고차원 데이터를 시각화할 수 있습니다.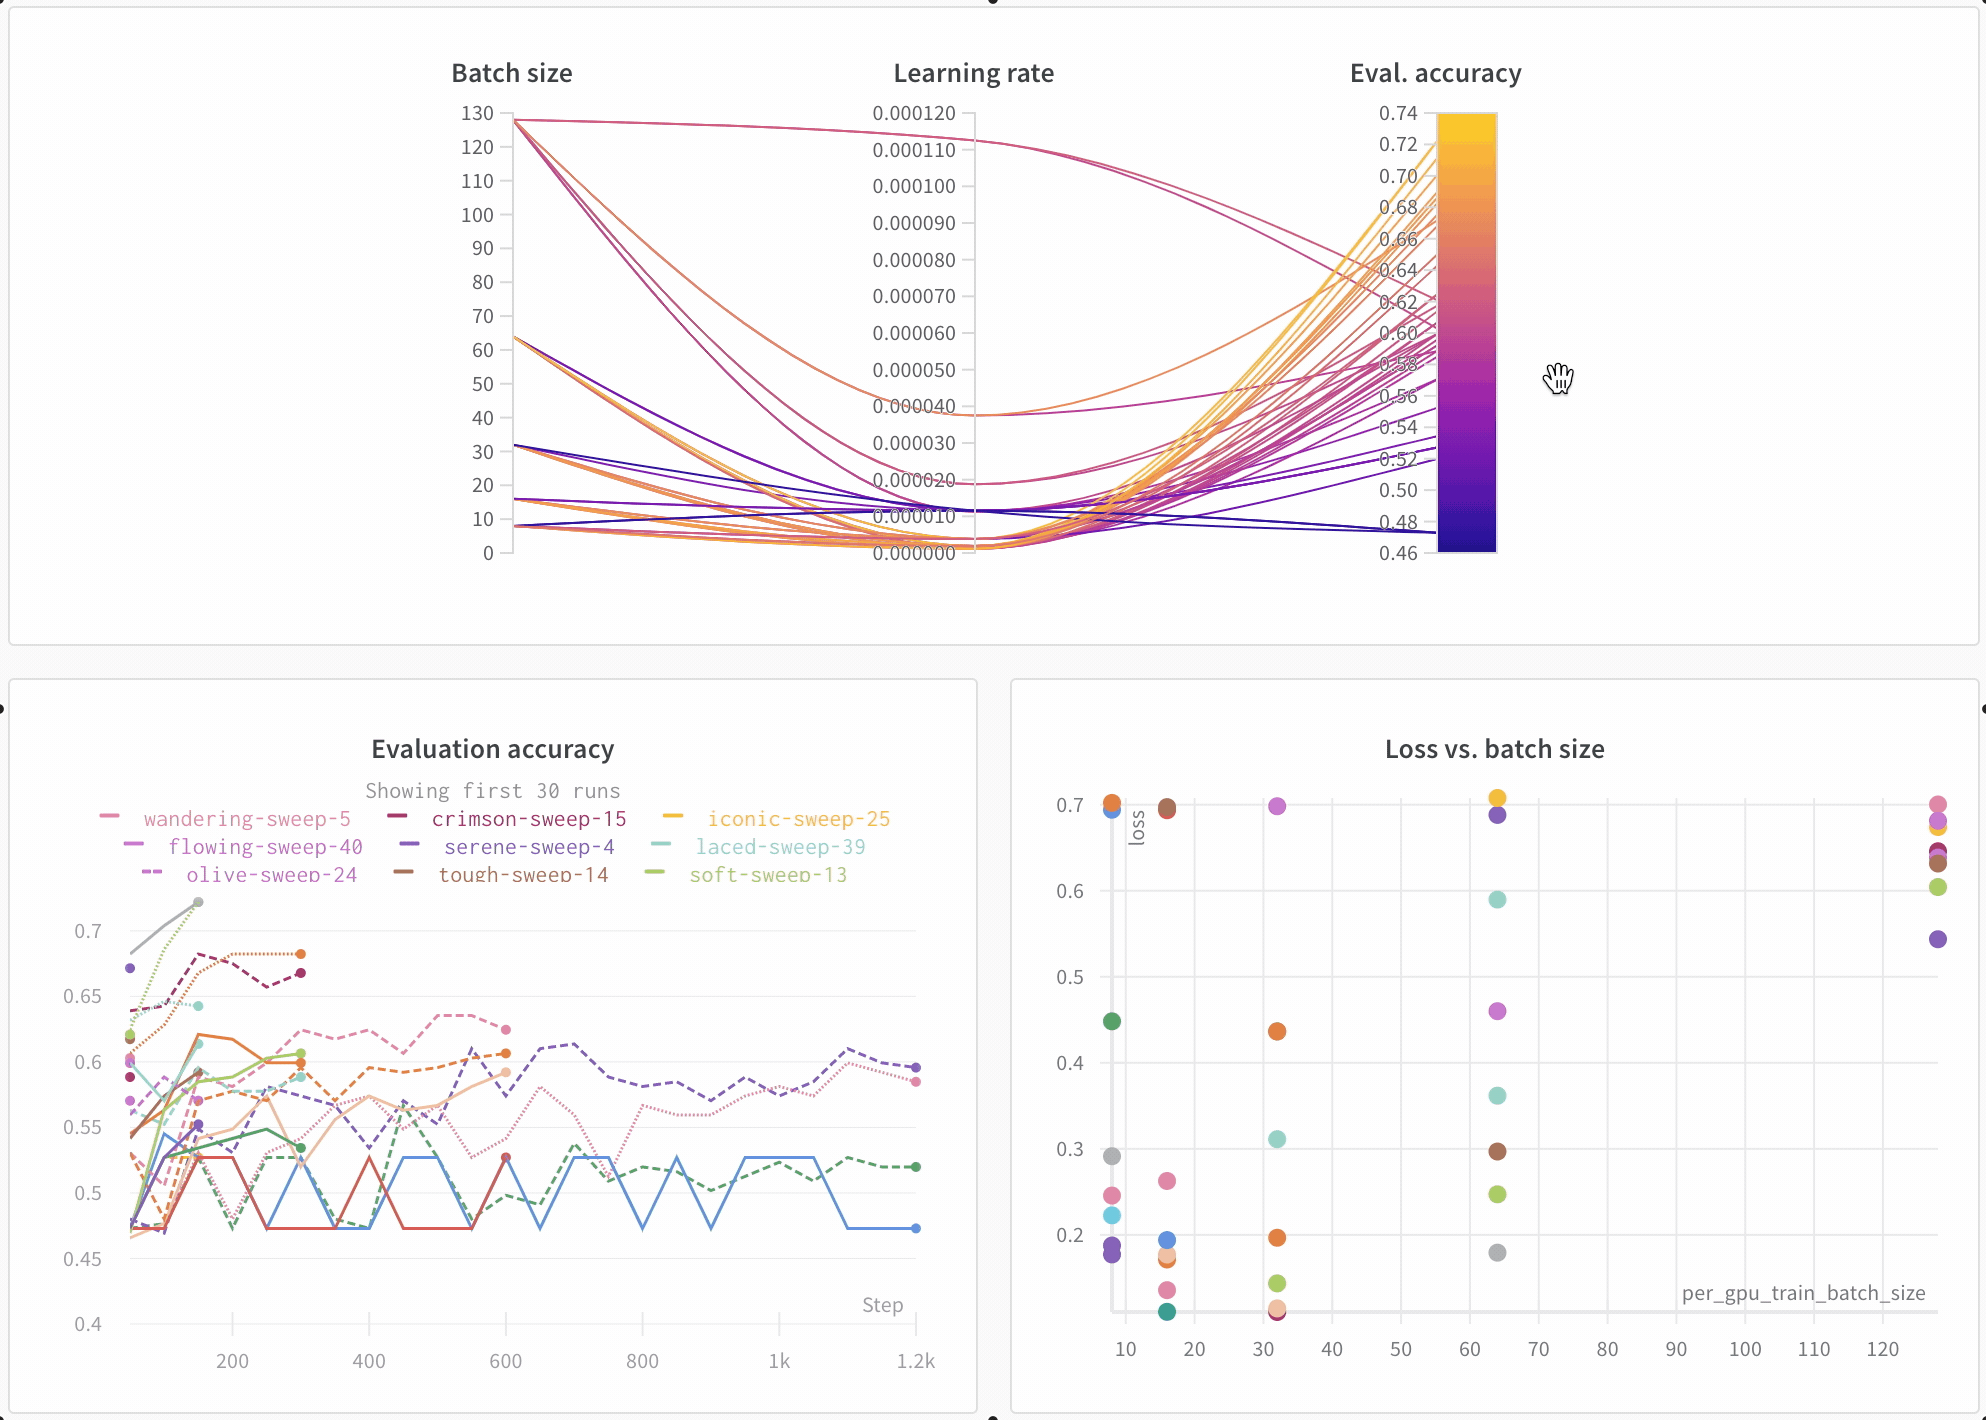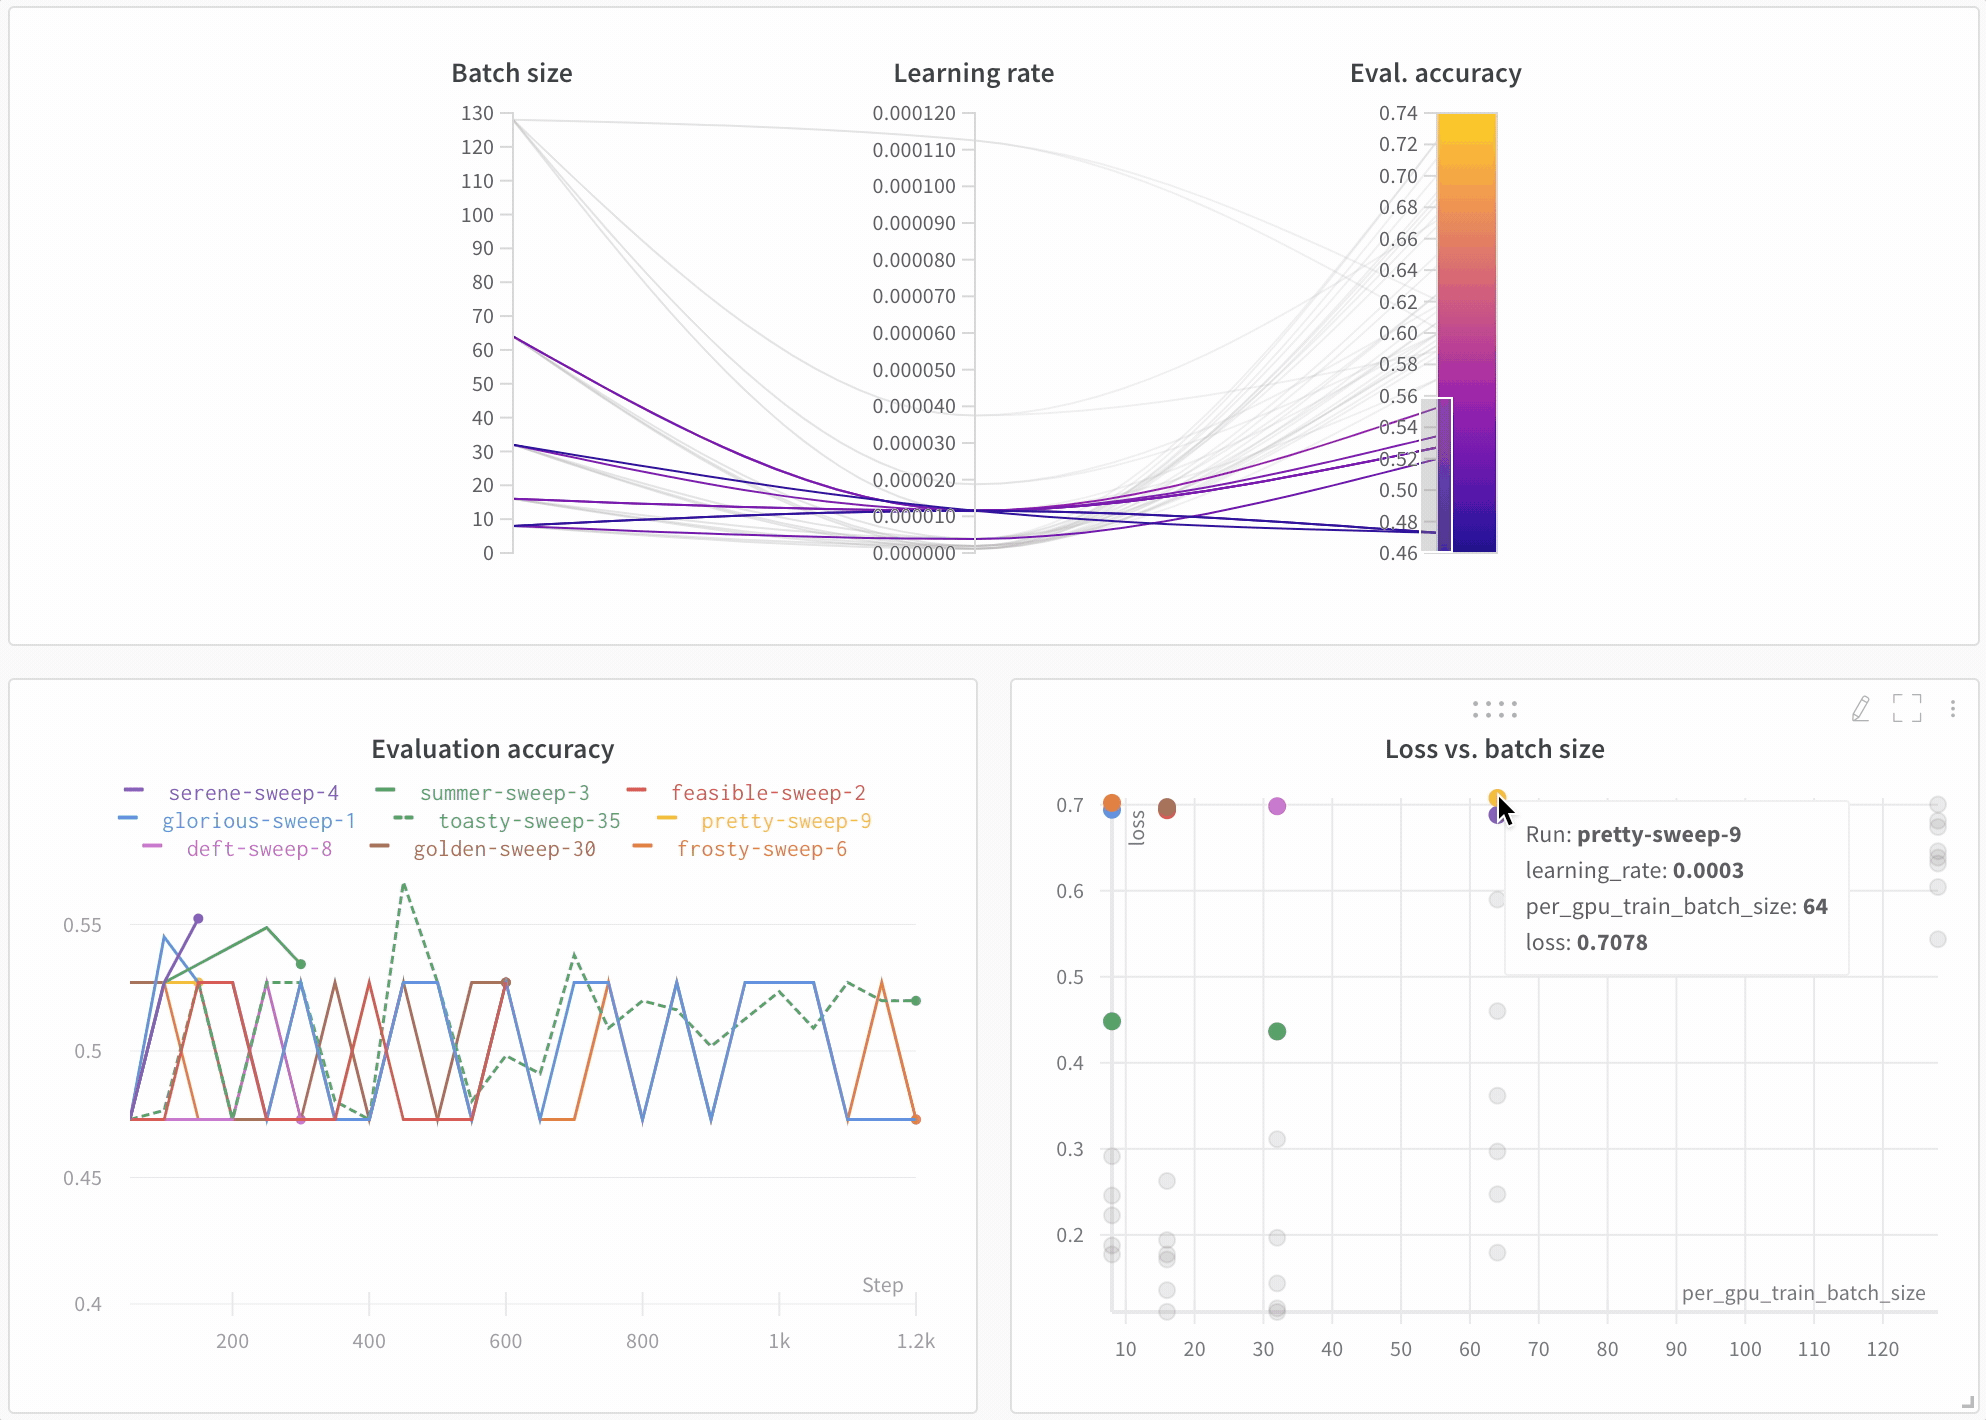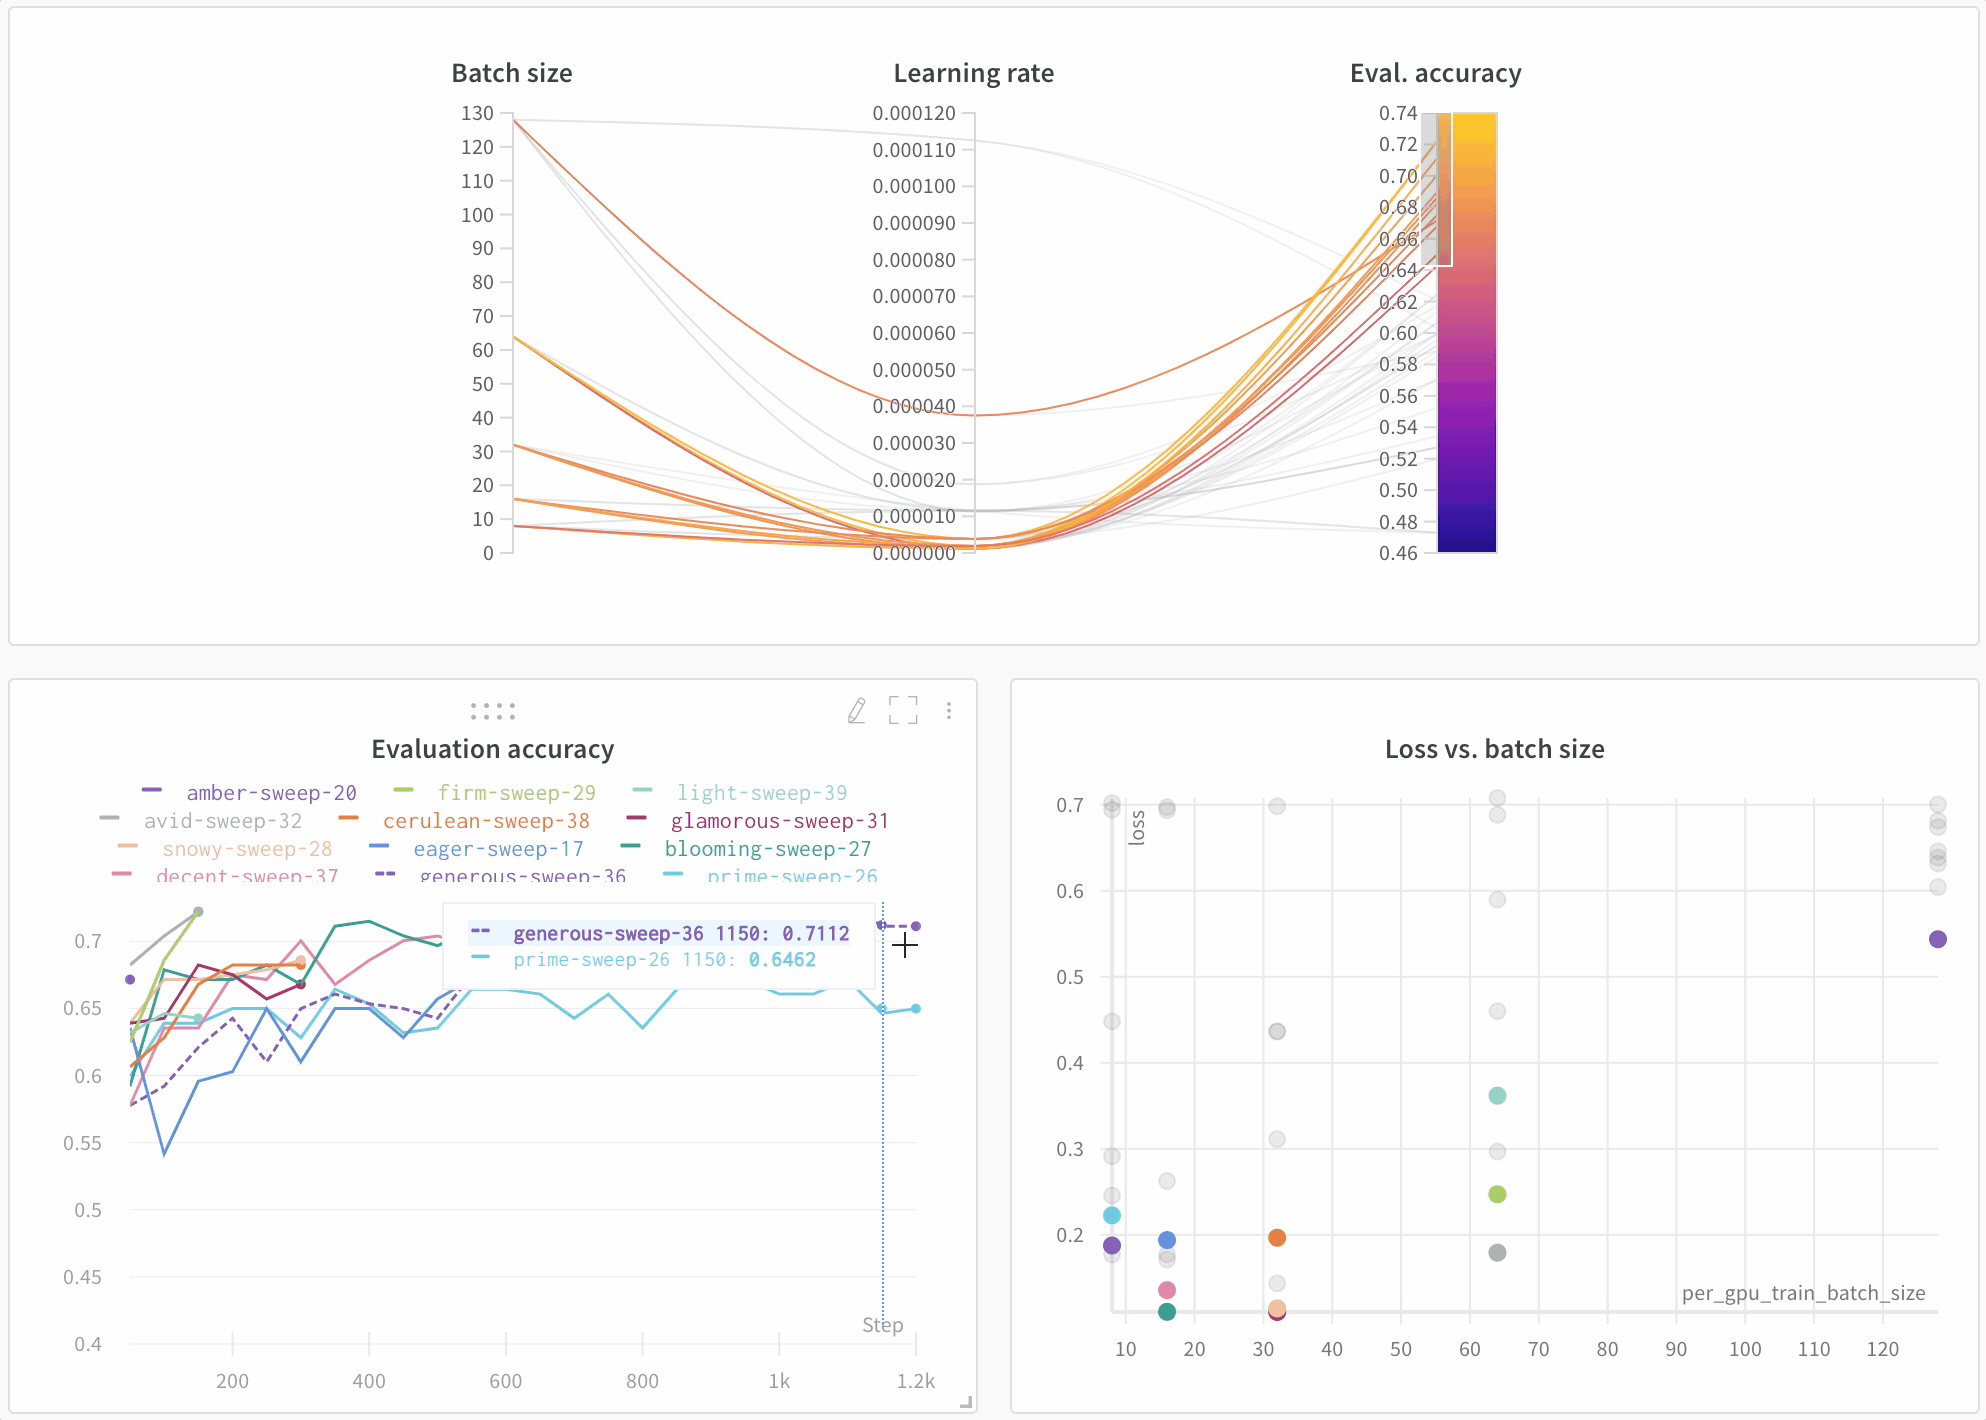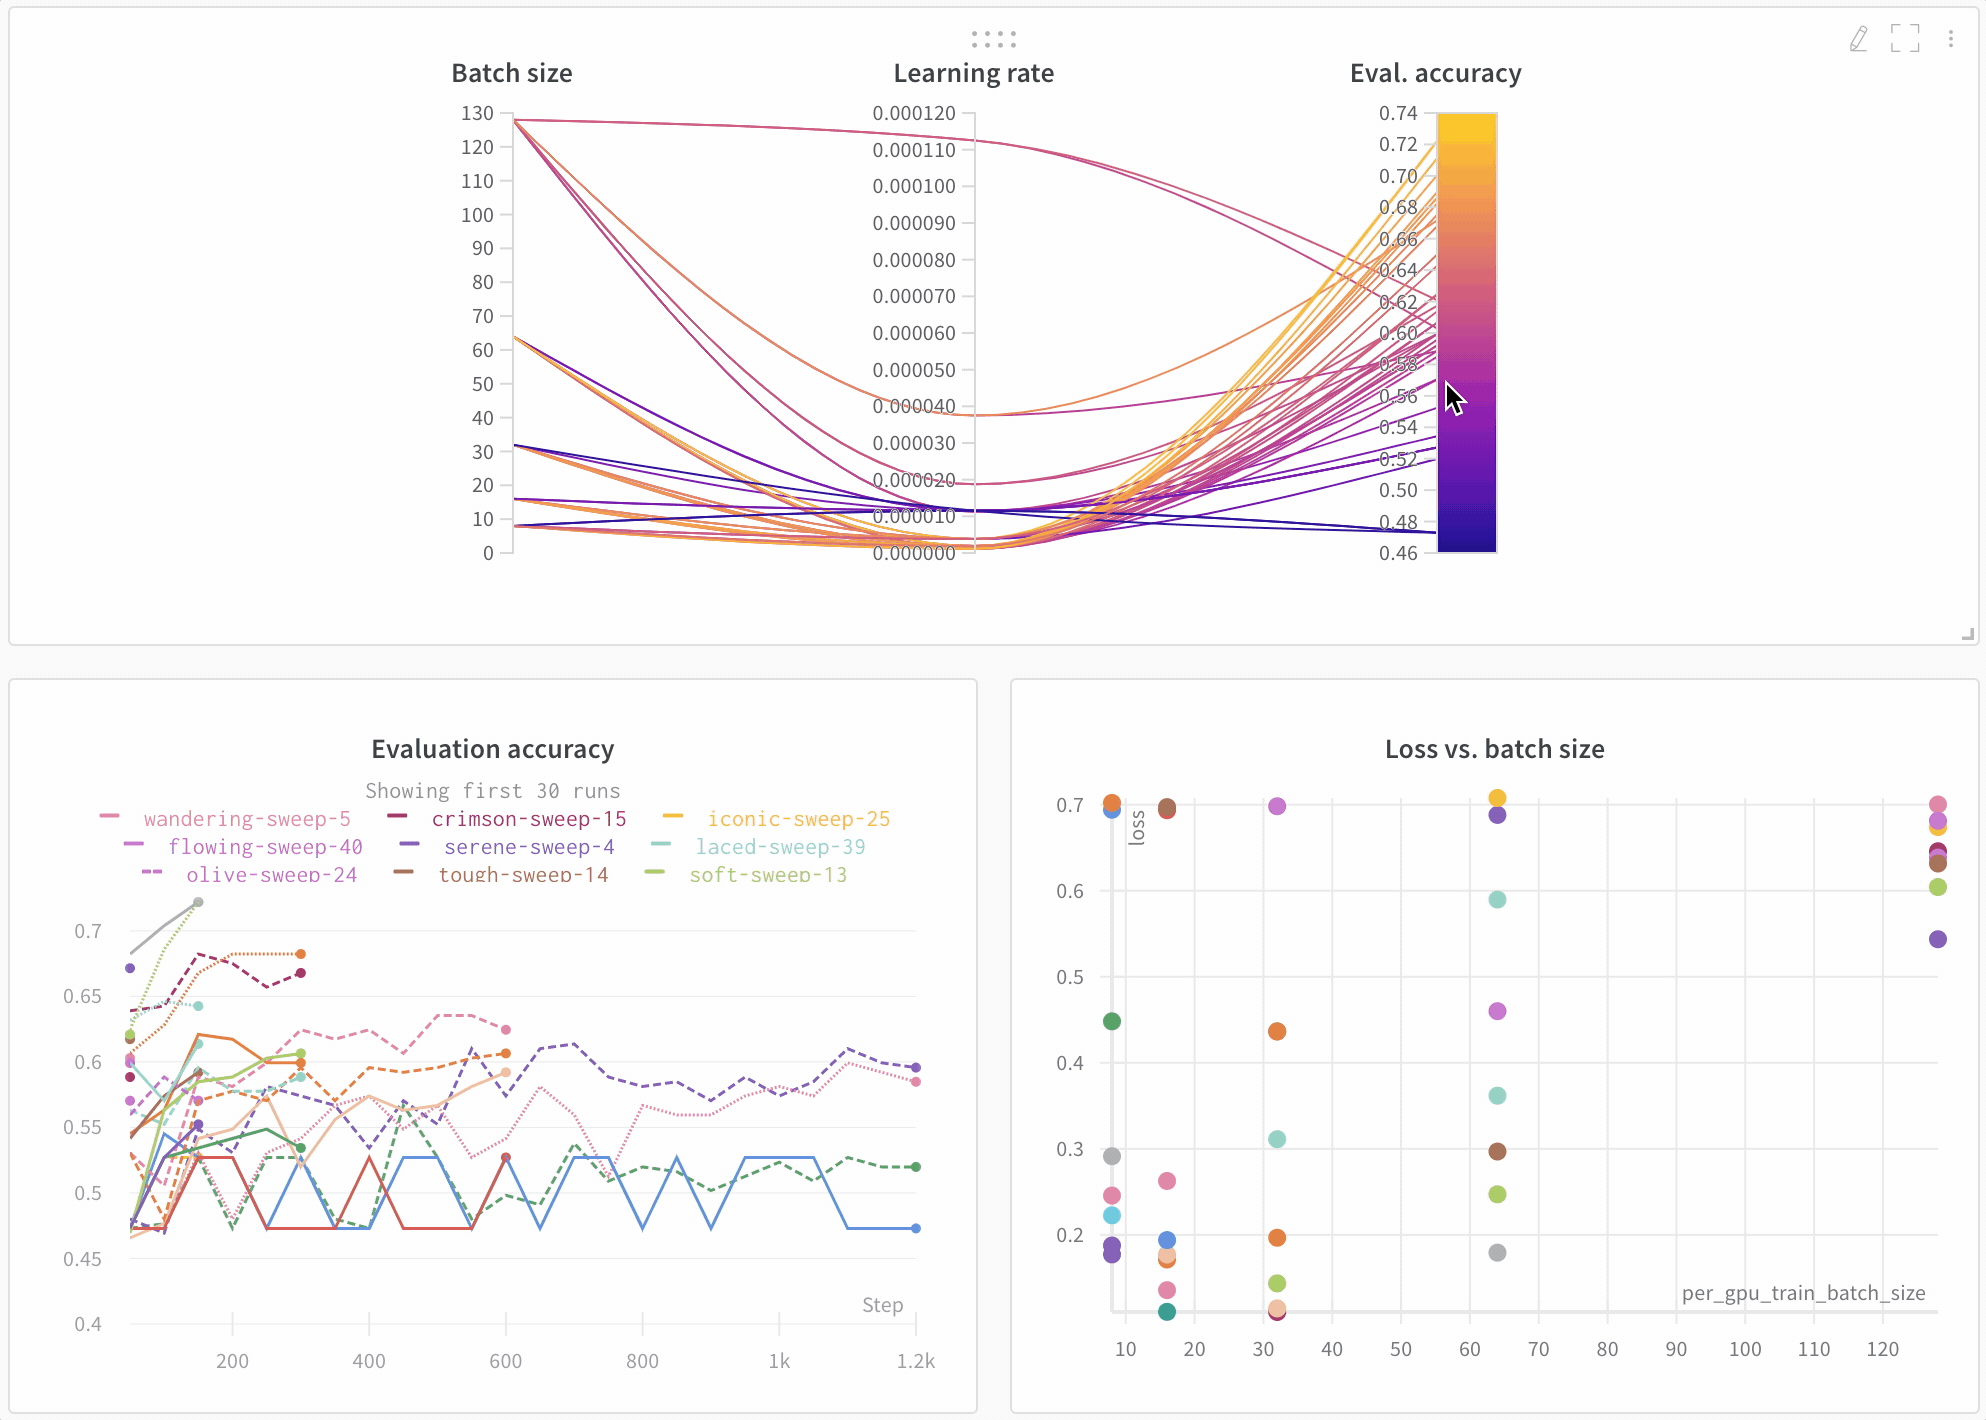
아키텍처 비교
다음은 BERT versus DistilBERT를 비교한 예시입니다. 자동 선 그래프 시각화는 서로 다른 아키텍처가 트레이닝 전반에 걸쳐 평가 정확도에 어떤 영향을 미치는지 보여줍니다.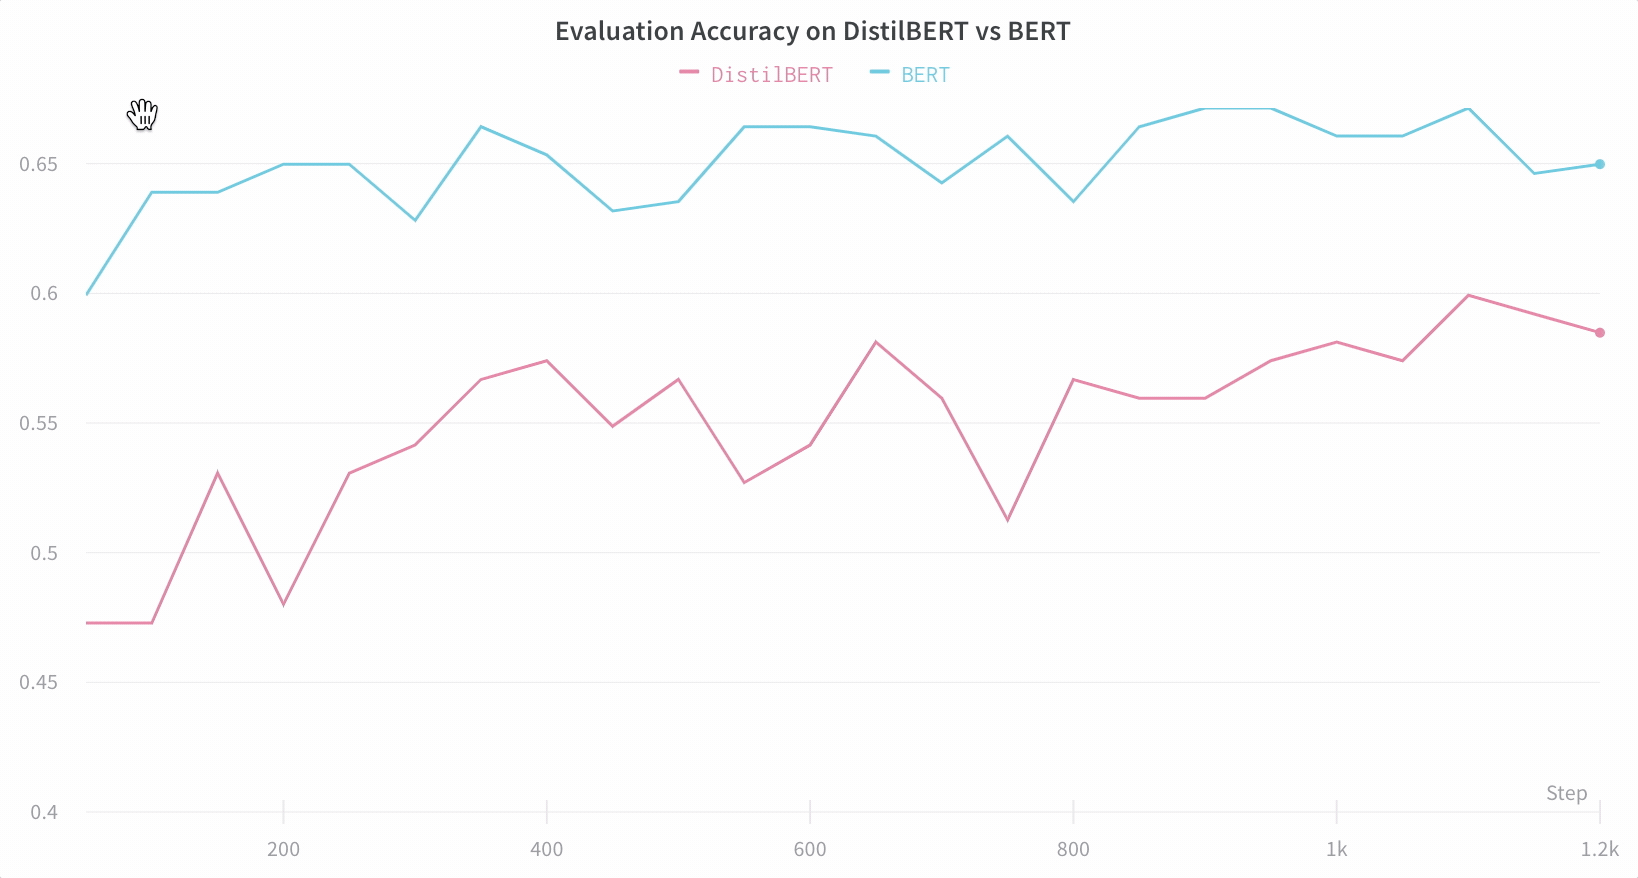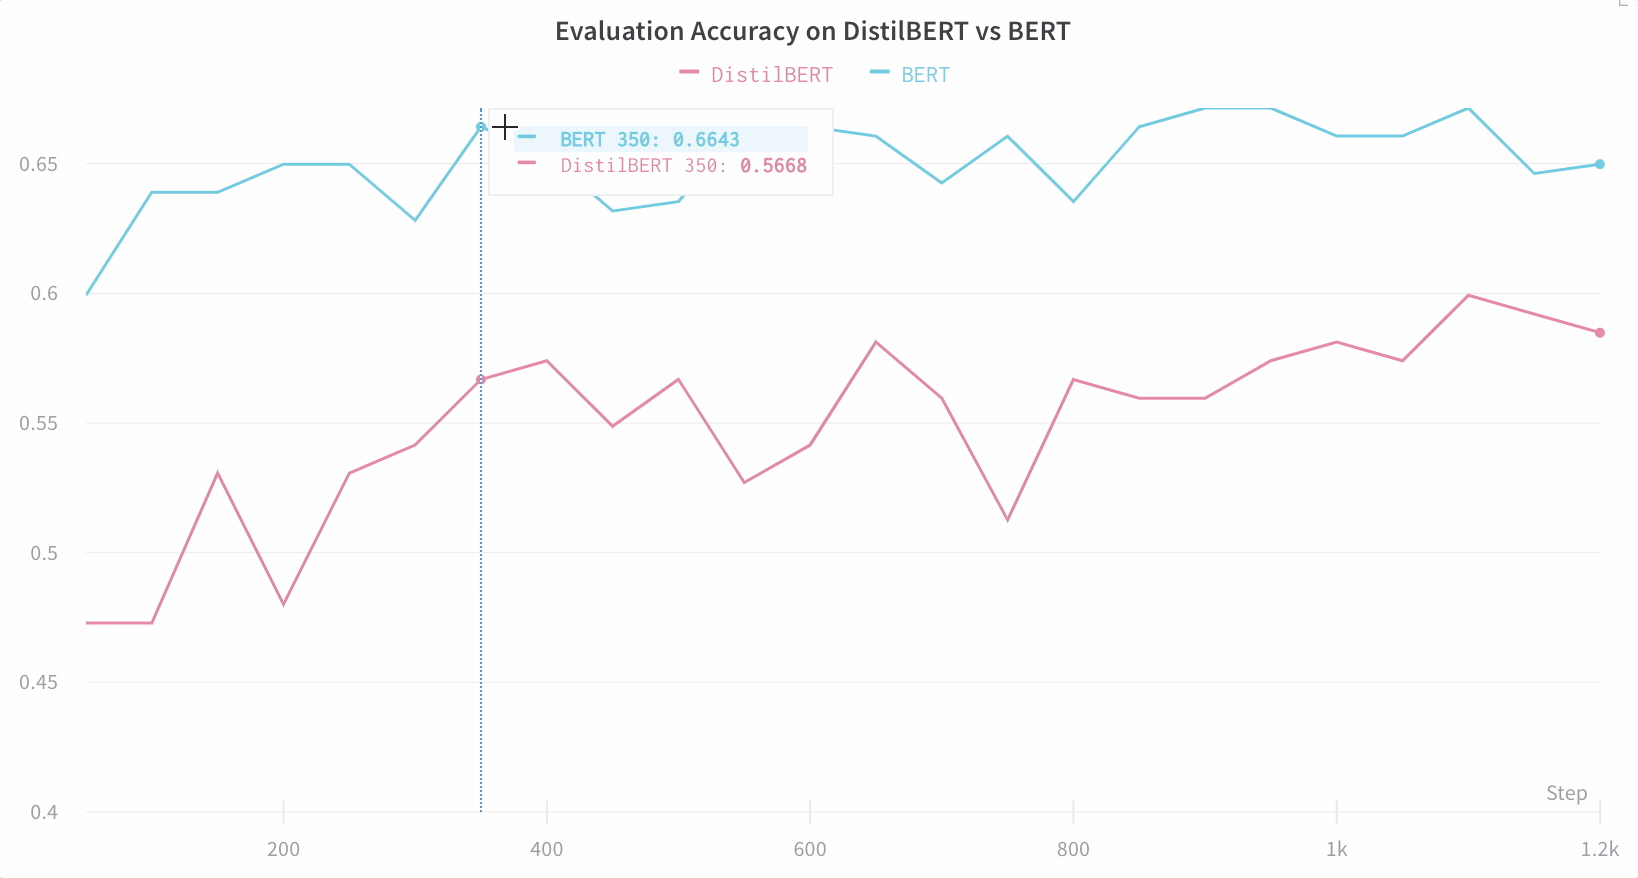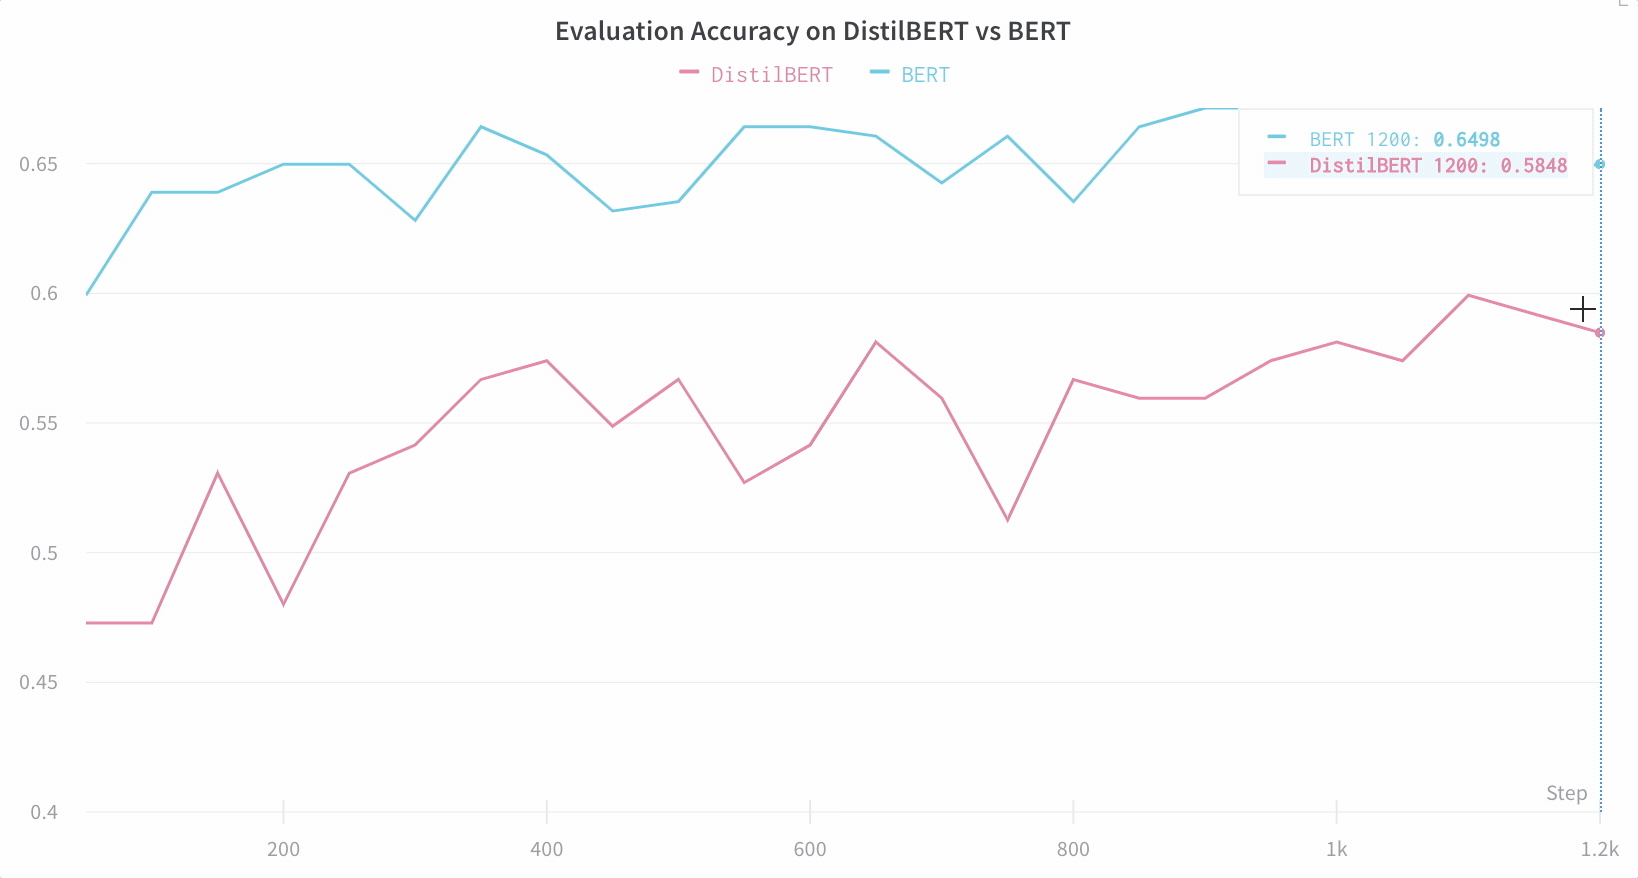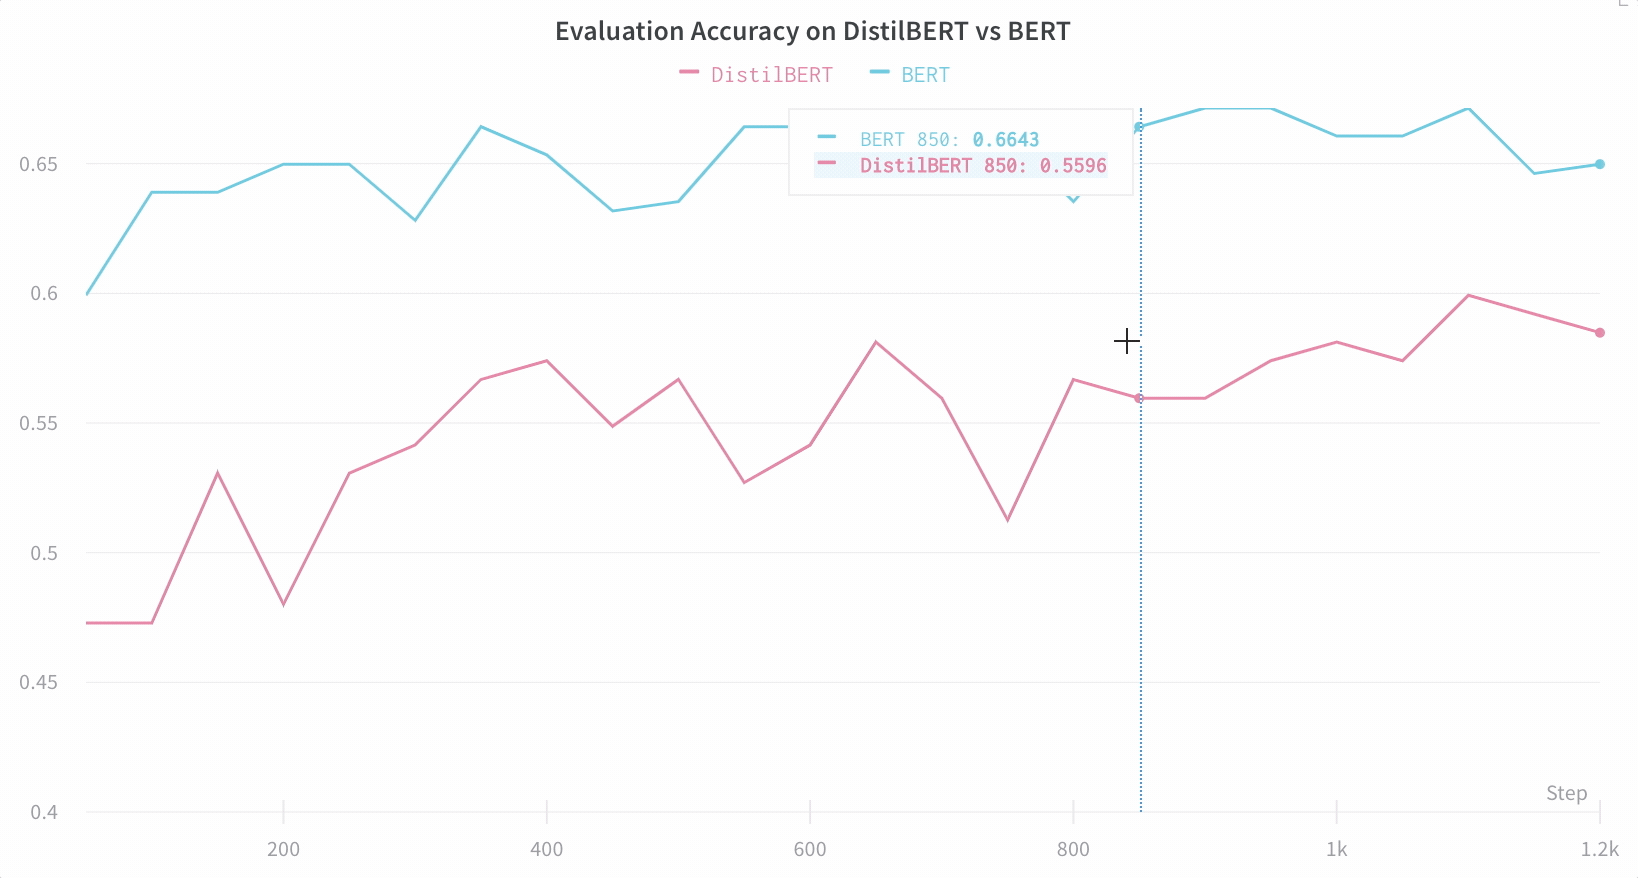
기본적으로 주요 정보를 추적합니다
이 섹션에서는 추가 설정 없이도 대시보드에서 어떤 데이터를 확인할 수 있는지 알 수 있도록 W&B가 자동으로 수집하는 정보를 설명합니다. W&B는 각 실험에 대해 새 run을 저장합니다. 다음은 기본적으로 저장되는 정보입니다.- 하이퍼파라미터: W&B는 모델의 설정을 Config에 저장합니다.
- 모델 메트릭: W&B는 Log로 스트리밍되는 메트릭의 시계열 데이터를 저장합니다.
- 터미널 로그: W&B는 명령줄 출력을 저장하고 탭에서 확인할 수 있게 합니다.
- 시스템 메트릭: GPU 및 CPU 사용량, 메모리, 온도.