

W&B 실험을 생성하는 방법
다음 네 단계로 W&B 실험을 생성하세요:W&B run 초기화
wandb.init()을 사용해 W&B run을 생성합니다.
다음 스니펫은 “cat-classification”라는 이름의 W&B 프로젝트에서, 이 run을 쉽게 파악할 수 있도록 설명을 “My first experiment”로 지정해 run을 생성합니다. “baseline” 및 “paper1” 태그도 포함되어 있으며, 이 run이 향후 논문 출판을 위한 기준선 실험임을 나타냅니다.
wandb.init()은 Run 객체를 반환합니다.
참고:
wandb.init()을 호출할 때 해당 프로젝트가 이미 존재하면 Runs는 기존 프로젝트에 추가됩니다. 예를 들어 “cat-classification”이라는 프로젝트가 이미 있으면, 그 프로젝트는 계속 유지되며 삭제되지 않습니다. 대신 해당 프로젝트에 새 run이 추가됩니다.하이퍼파라미터 딕셔너리 기록하기
학습률이나 모델 유형과 같은 하이퍼파라미터를 딕셔너리로 저장합니다. 설정에 저장해 둔 모델 설정은 나중에 결과를 정리하고 쿼리하는 데 유용합니다.트레이닝 루프 내에서 메트릭 로깅하기
accuracy, loss와 같은 각 트레이닝 step의 메트릭을 로깅하려면run.log()을 호출하세요.
W&B에 Artifact 로깅하기
선택적으로 W&B Artifact를 로깅할 수 있습니다. Artifacts를 사용하면 데이터셋과 모델의 버전을 쉽게 관리할 수 있습니다.모두 종합하기
앞서 살펴본 코드 스니펫을 모두 포함한 전체 스크립트는 아래와 같습니다:다음 단계: 실험 시각화
프로젝트의 Workspace를 머신 러닝 모델의 결과를 정리하고 시각화하는 공간으로 활용하세요. 병렬 좌표 플롯, 파라미터 중요도 분석, 기타 차트 유형과 같은 대화형 차트를 만들 수 있습니다.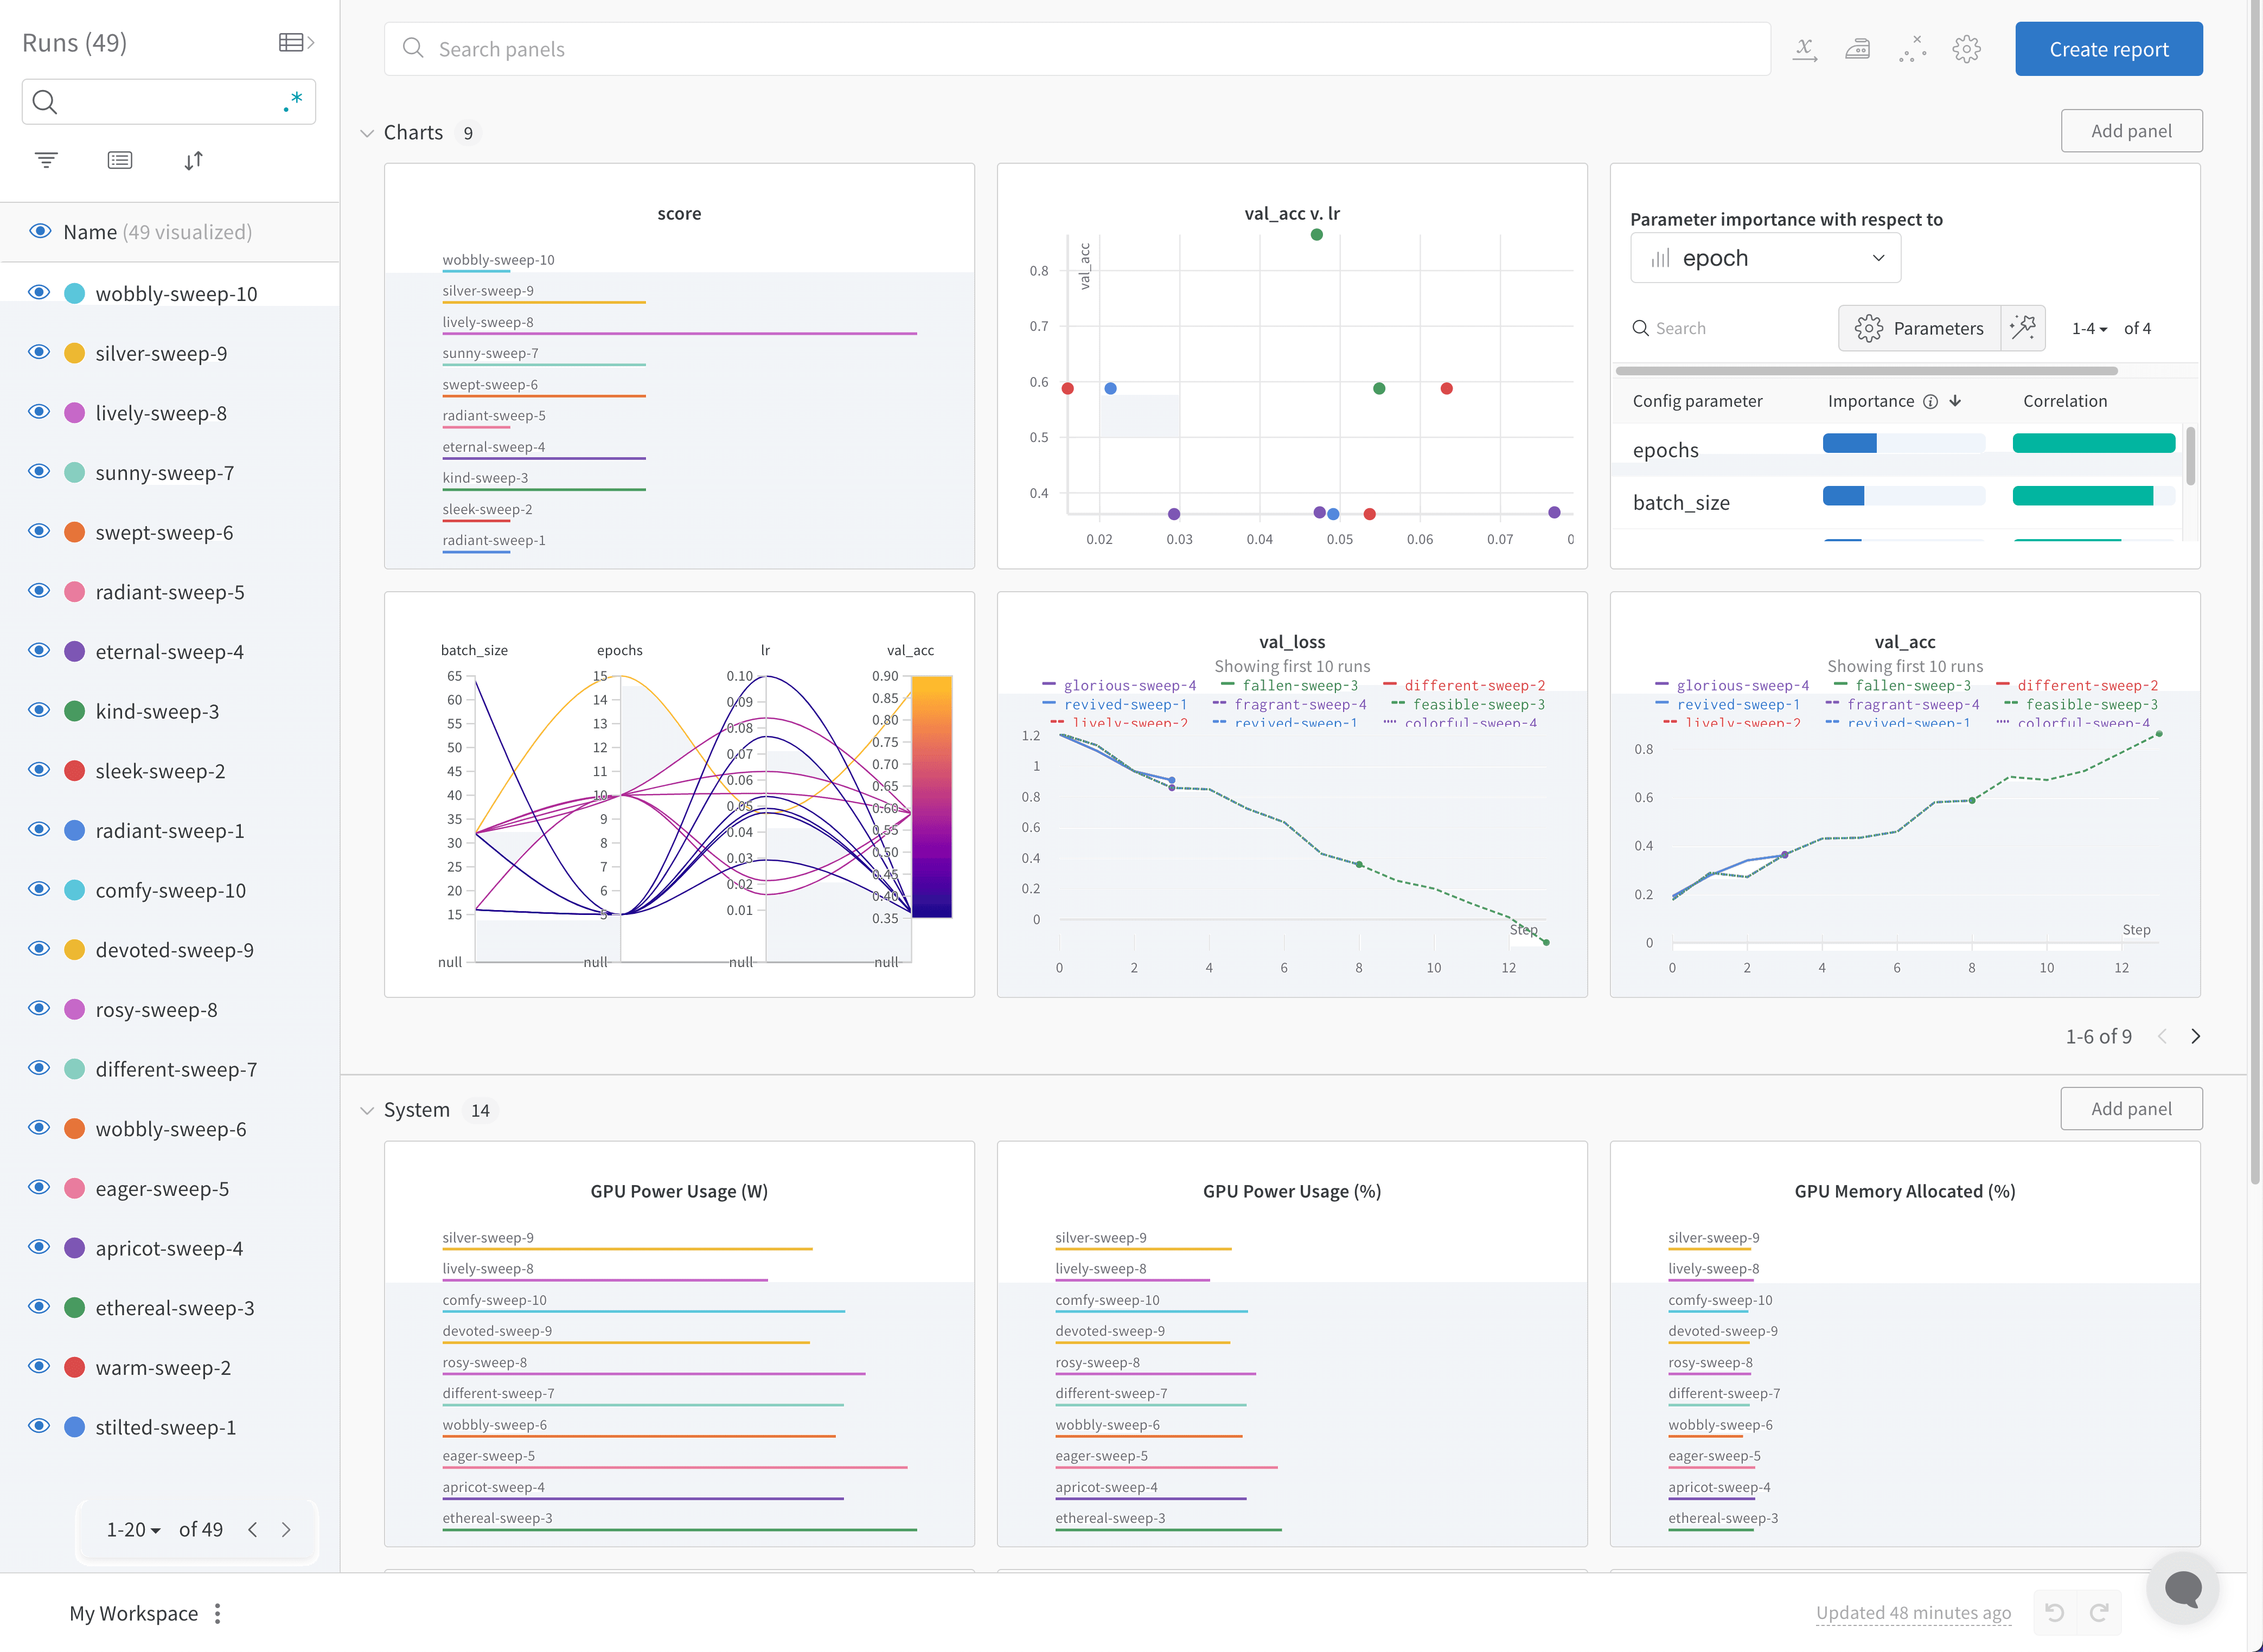
모범 사례
다음은 실험을 만들 때 고려할 수 있는 몇 가지 권장 지침입니다.- 컨텍스트 관리자로 Runs 관리:
with문에서wandb.init()를 사용하면 코드 실행이 끝나거나 예외가 발생했을 때 run이 자동으로 종료됩니다.-
Jupyter notebook에서는 run object를 직접 관리하는 편이 더 나을 수 있습니다. 이 경우
finish()를 호출해 완료로 표시하세요.
-
Jupyter notebook에서는 run object를 직접 관리하는 편이 더 나을 수 있습니다. 이 경우
- Config: 모델을 재현하는 데 필요한 하이퍼파라미터, 모델 아키텍처, 데이터셋 정보 및 기타 값을 추적하세요. 자세한 내용은 View the config in the Overview section of a run in the W&B App을 참고하세요.
- Project: projects를 사용해 실험을 한곳에서 구성하세요. 여기에서 결과를 시각화하고, Runs를 비교하고, 아티팩트를 보고 다운로드하고, 자동화를 만들 수 있습니다.
- Notes:
baseline model또는tuned hyperparameters처럼 run의 목적을 설명하는 notes를 추가하세요. 나중에 W&B App의 run 개요에서 notes를 편집할 수 있습니다. - Job types: 작업(
train,test,inference등)별로 Runs를 구성하고 필터링할 수 있도록 Runs에 job type 추가하세요. - Tags: 로깅된 메트릭이나 아티팩트만으로는 분명하지 않을 수 있는 특성이나 속성으로 Runs에 레이블을 지정하려면 Runs에 tags 추가하세요.
wandb.init()을 참조하세요.