

基本例: Llama 3.1 8B を Weave でトレースする
この例では、Llama 3.1 8B モデルにプロンプトを送信し、その call を Weave でトレースする方法を示します。トレースでは、LLM call の入力と出力を完全に取得し、パフォーマンスを監視して、Weave UI で結果を分析できます。 この例では、次のことを行います。- Chat Completion リクエストを行う
@weave.op()デコレータ付きの関数を定義します。 - Weave がトレースを記録し、W&B の entity と project にリンクします。
- Weave が関数を自動的にトレースし、入力、出力、レイテンシ、メタデータをログします。
- 結果はターミナルに出力され、トレースは https://wandb.ai の トレース タブに表示されます。
- ターミナルに出力されたリンクをクリックします。たとえば、
https://wandb.ai/[YOUR-TEAM]/[YOUR-PROJECT]/r/call/01977f8f-839d-7dda-b0c2-27292ef0e04g。 - https://wandb.ai にアクセスして トレース タブを選択します。
高度な例: Weave 評価とリーダーボードを使用する
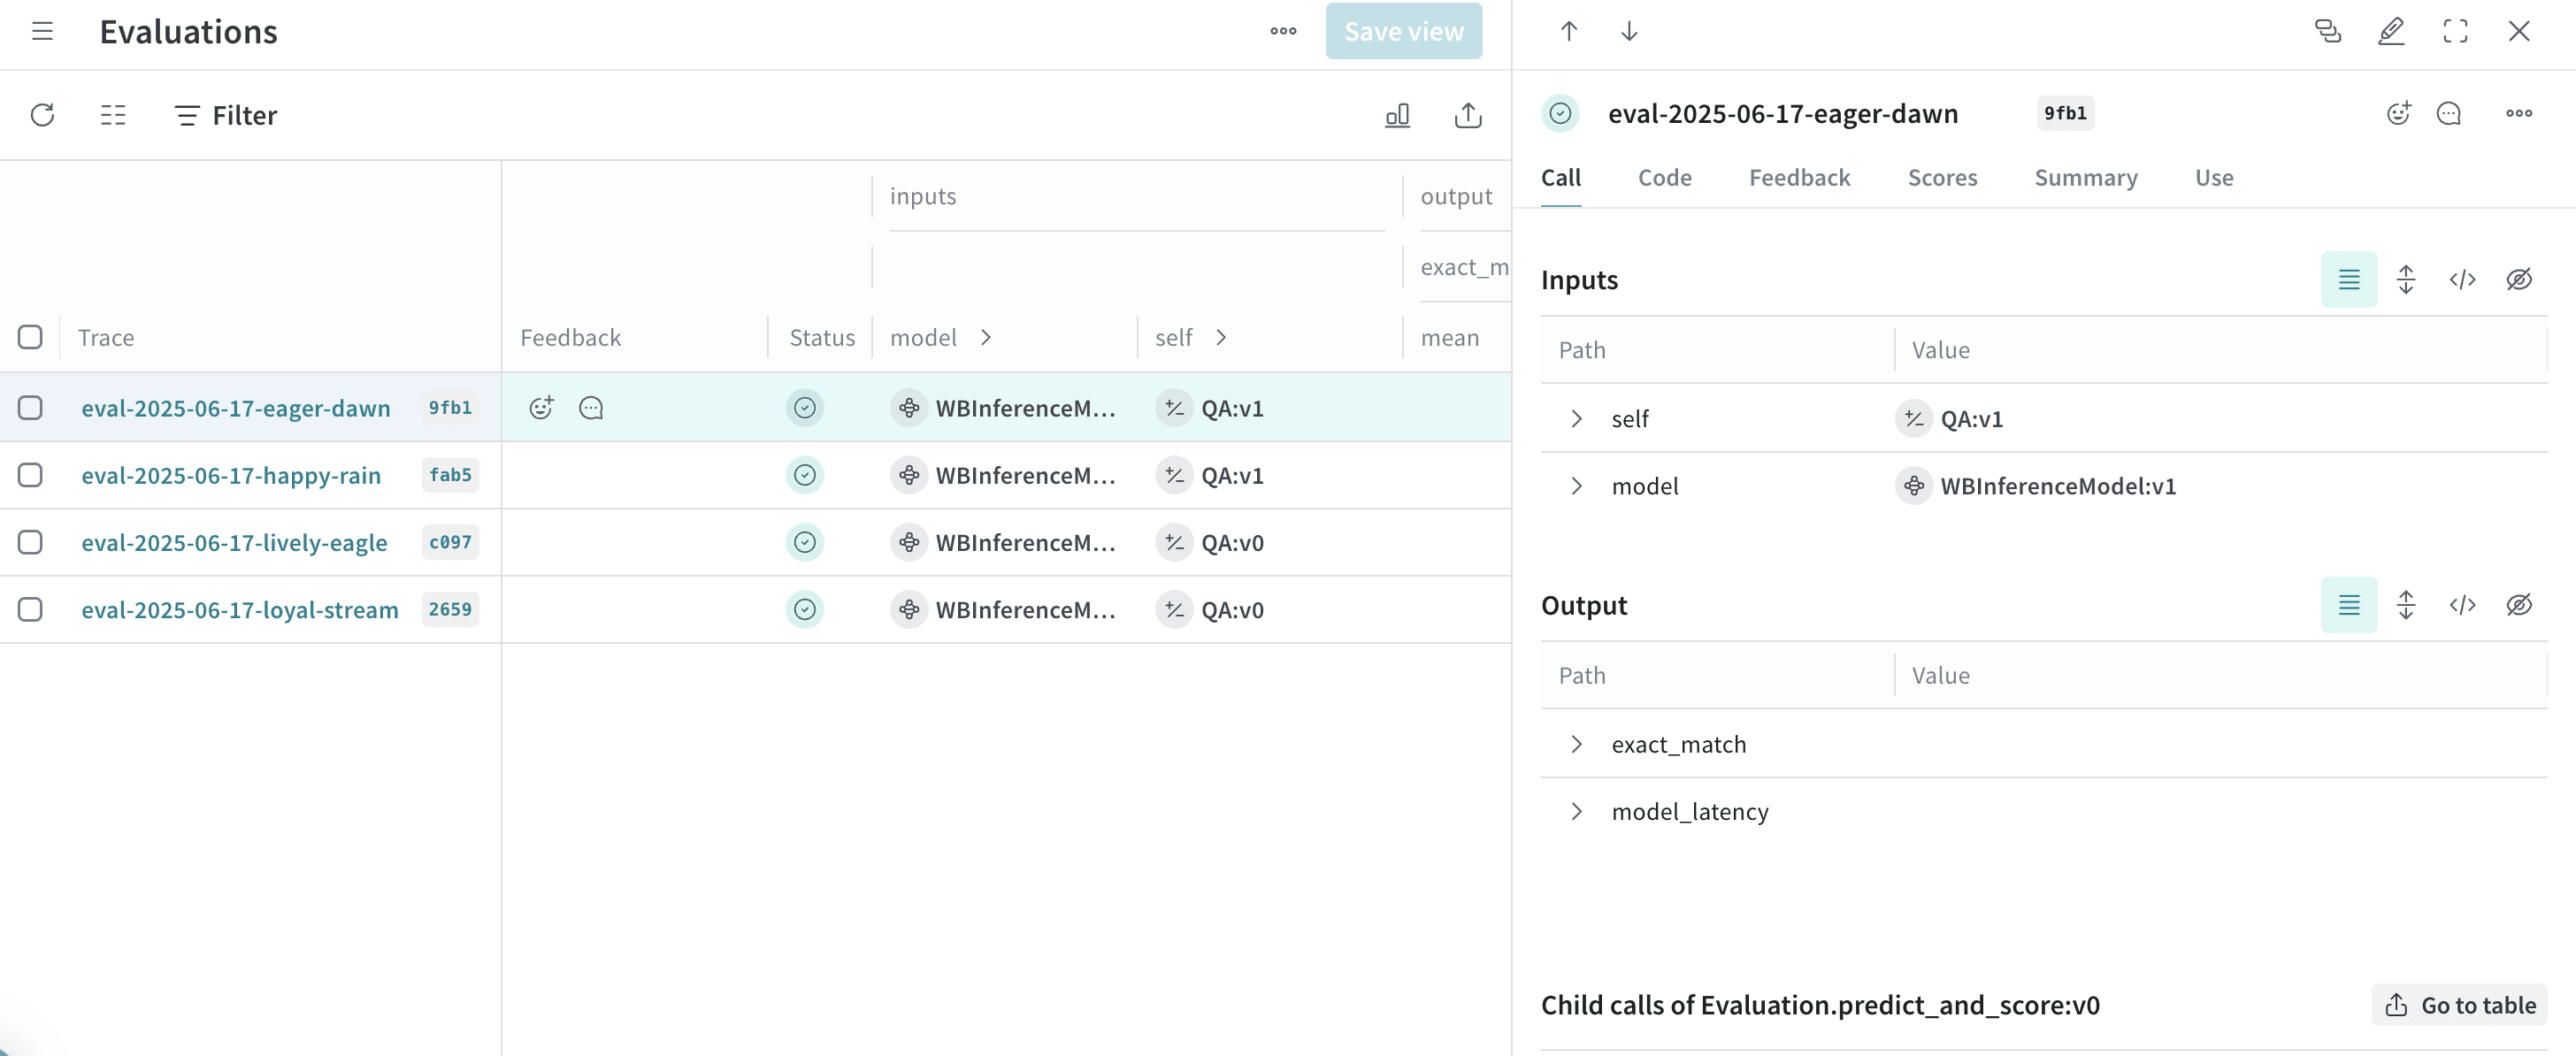
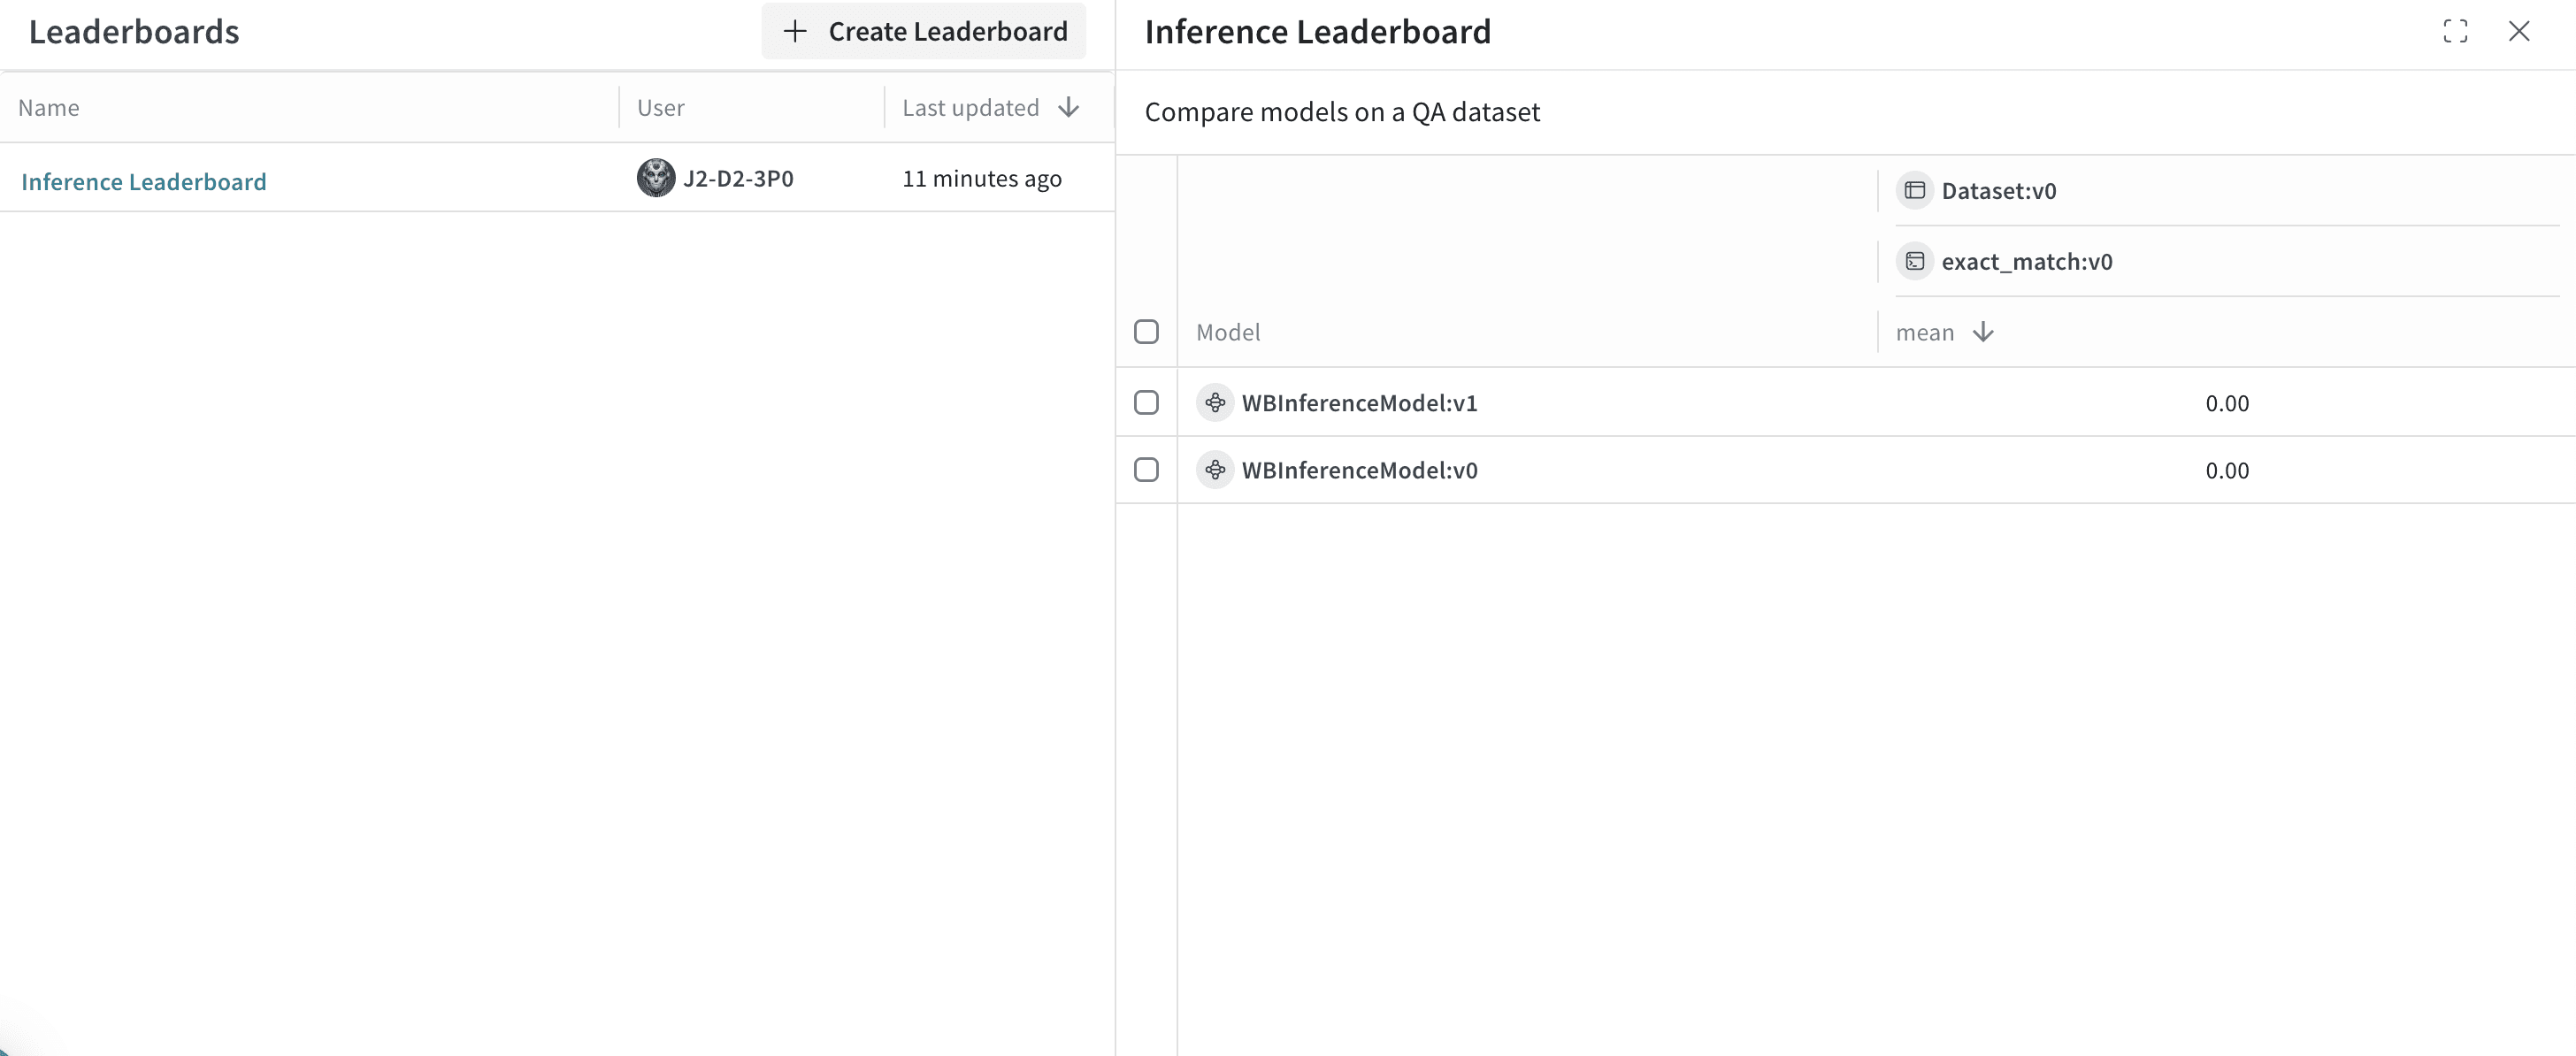
モデルのcallのトレースに加えて、パフォーマンスを評価し、リーダーボードを公開できます。この例では、質問応答データセット上で2つのモデルを比較し、同じプロンプトに対して Llama 3.1 8B と DeepSeek V3.1 がどのようなパフォーマンスを示すかを確認します。- トレース タブを選択して、トレースを確認します。
- Evals タブを選択して、モデルの評価を確認します。
- Leaders タブを選択して、生成されたリーダーボードを確認します。
次のステップ
Serverless Inference の探索を続けるには、次を試してください。- 利用可能なすべての method は、API リファレンスで確認してください。
- UIでモデルを試してください。